


哈哈,居然撑到第二期了.jpg
让我们用 ICLR 2026 submission 的新闻开场吧。
1. Mamba-3
标题:Mamba-3: Improved Sequence Modeling using State Space Principles
概览:Mamba-3 仍然坚持使用 SSM 范式,整体来说感觉是一个理论贡献大于实际贡献的文章。改动在于:
-
在离散化中使用推广梯形法则替代欧拉法的零阶保持,说人话就是在估计区间积分的时候把替代点从区间的左端点换成了自适应的某个中间插值点。并证明了这种方式与 short conv 能够形成类似的 pattern,能够代替 short conv 的作用。这是我个人最不认可的一点,因为它推出来长下面这样。这和直接算卷积有什么不一样吗我请问了()算是从 SSM 视角提供了一个理论贡献吧。
-
状态转移矩阵复值化。原本 SSM 的转移矩阵就是复值的,在发展到 mamba-2 的过程中逐渐简化掉了。但在简化的过程中损伤了模型的状态追踪能力,因此 mamba-3 又加回来了。它证明复值的转移矩阵等价于 2x2 diagonal block 构成的转移矩阵,又等价于在 BC 两个矩阵上施加有数据依赖的 RoPE(具体没看)。这是我个人最感兴趣的一点,但这个问题应该挺值得挖掘的。
-
为了在 decoding phase 达到 compute bound,mamba-3 选择在状态更新中再加一个维度增加计算量,反正挺离谱的。这个改动实际上提高了推理延迟,但是应该提高了算术强度。作者或许也觉得这个改动不是特别妥当,是一个可选项。
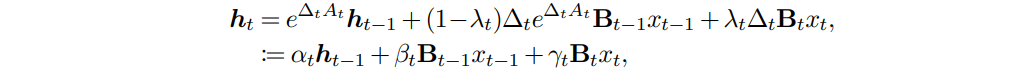
测试是标准的 100B token 训练,但是长度只有 2k,他们或许根本就没有想做外推。常规任务和 gated delta 有来有回,最多也就是几个点。长文本情况也差不多,比 mamba-2 好点。不知道涨点是从哪里来的,没有 ablation 环节。
2. Twilight
标题:Twilight: Adaptive Attention Sparsity with Hierarchical Top-p Pruning
概览:简单来说就是 top-p selection。常用的 top-k selection 有很显著的缺陷,即 k 是手动指定的,这意味着 top-k sparse attention 的内存预算和 sliding window attention 实际上是一样的,只不过它可以自己决定这个空间里可以放什么。显然不是所有时候都可以一个恒定的内存预算中完成全部的任务;top-k 只是算起来比较简单而已(指在内核编写上)。
这篇文章其实就没有别的内容了。其他的部分都是非常工业的考虑,比如 top-p 对 kv cache 的精度要求比 top-k 要高,因为 top-k 实际上只要比较 attention score 之间的相对大小,甚至不需要经过 softmax 就可以选出需要的 token。但是 top-p 是确实需要选出 attention score 总和超过阈值的 token,因此有更高的精度要求,但实际上也只是 4bit kv cache 而已。另外还有 top-p 如何计算的问题,因为朴素的 top-p 计算需要累加的操作。文中的 kernel 是从 FlashInfer 改编来的,使用的是二分查找的方式;即确定一个下界,一个上界,一个中间的 pivot,看看 pivot 到最大值之间的值加起来是不是超过 p。如果是,说明选多了,pivot 上移;如果不是,说明选少了,pivot 下移。另外整个方法是建立在传统的 top-k 方法之上的,它使用 top-k 进行粗选(保留 1/4 上下文的预算),然后再使用 top-p 进行精细的选择。也就是题目中 hierarchical 的来源。
3. DeepSeek-OCR
标题:DeepSeek-OCR: Contexts Optical Compression
概览:上一版同步的时候被吞了,重新写一遍。这个模型本质上是一个文本上的 autoencoder,输入是含有文字的图片,输出是原始的文本。通过视觉处理中的降采样压缩 latent space 中的 token,实现了相比文本 tokenizer 大约 10x 的空间压缩,同时保留文本还原的精度(即依然能够从 latent space 中还原出原始的文本)。它通过这种方式证明,传统的文本模态实际上存在很大的压缩空间。
4. Cognitive Map Learner
标题:Local prediction-learning in high-dimensional spaces enables neural networks to plan
概览:Wolfgang Maass 在 talk 中提到的工作,是一个尝试使用基本的可塑性规则进行 planning 的工作。两个 one-hot 编码的向量,一个是 observation,或者说当前的状态;一个是 action,或者说当前能够采取的行动。这两个 one-hot 编码分别使用一个权重矩阵编码到一个相同的空间中去,并且进行预测编码,即
以这个目标进行 loss 和 backprop,将会得到和的更新方程,全部都遵循 Hebb 规则。当这两个矩阵大致符合上面的规则之后,实际上就建立了一个待求解问题的 cognitive map。比如,待求解问题是图上最短路径,在图上先进行随机游走,通过的样本更新以上权重。这里的 observation 实际上就是当前的 node,action 就是允许的边,下一个 observation 就是下一个节点。当更新完成之后,权重中实际上包含了对整个图的形态的认知。
在完成建模之后,可以进行决策。在得到的空间中,所有的 state/observation 被视为点坐标,而一个 action 被视为一个位移,决策实际上就是找出一系列的 action,使其能够完成源 observation 和目标 observation 之间的位移。要完成最优化则采用贪心策略,即通过当前状态与目标状态之间相差的方位和待检查的 action 之间的点积来进行判断。寻找最优的 action 就是把所有的 action 都进行一次度量,然后使用 winner-take-all 的策略选出一个 action。
为了能够使用贪心策略,实际上要求所有的 之间大致是正交的,另外还要求所有的 之间模长大致相同。这是通过从高斯分布中随机初始化完成的(近似正交,并指望模长在训练中保持稳定)。
这个模型包含了 Markov 性质的假设,即当前的 action 仅仅是由当前的 observation 决定的。另外在文章最后一部分说明了和 attention 的相似性。这个决策过程实际上看起来就是很像 atttention:使用当前的,检查所有的,然后使用 top-1 而非 softmax 的策略进行选择,key 和 value 是一样的。
5. LoopLM
标题:Scaling Latent Reasoning via Looped Language Models
概览:来自字节的工作,架构上是一个标准的 Transformer,循环的部分是 embed 之后、lmhead 之前的堆叠层,是把整体看作一个循环单位。最后接了一个 exit gate。因为是这样一个架构就没有再看下去,和 coconut 实际上差不多吧。更多是工业上的考虑。
6. Interactions between long- and short-term synaptic plasticity transform temporal neural representations into spatial
标题:如题
概览:和 tempotron 同类的工作,感觉意义不大,只作记录。主要探讨了 n 对 1 连接下,允许连接强度在单次 trial 的不同 spike 之间进行动态调整(短期 plasticity)可能带来的性能提高。如果调整策略足够聪明,使得在不同的 spike 之间进行任意的调整,那么实际上相当于变相地增加了突触的数量,作者称为 (ideal) ordinal plasticity。作为一个更实际的模型,作者验证了 Tsodyks–Markram model 递质传递模型带来的可塑性。实验证明 TM model 带来的可塑性增益大致相当于将权重数量翻倍。这实际上是时序上的增益(因为 plasticity 必须要在时间上起作用)向空间上的增益(权重翻倍)的等价,所以如题。
7. EFLA
标题:Error-Free Linear Attention is a Free Lunch: Exact Solution from Continuous-Time Dynamics
概览:建议直接看苏剑林的写法,一些数学的部分再回原文去补。它的主要贡献是给出了 delta rule 下的连续形式:
在后半部分的式子中,我们去掉了时间下标,因为在求解区间内,这两个矩阵暂时被视为恒定矩阵。需要注意的是,这种连续写法与SSM中的连续写法并不对应。DeltaNet可以视为上述连续过程单步离散化求解的结果,或者说最简单的ode离散方式。EFLA给出了连续形式的解析解,最后得到的式子看起来和DeltaNet基本是一致的,只不过规则自身携带了L2Norm的形式,并且写入门稍微复杂一些。效果上和DeltaNet没有差太多,因为形式上基本上也是一样的。
8. E2E-TTT
标题:End-to-End Test-Time Training for Long Context
概览:如图。
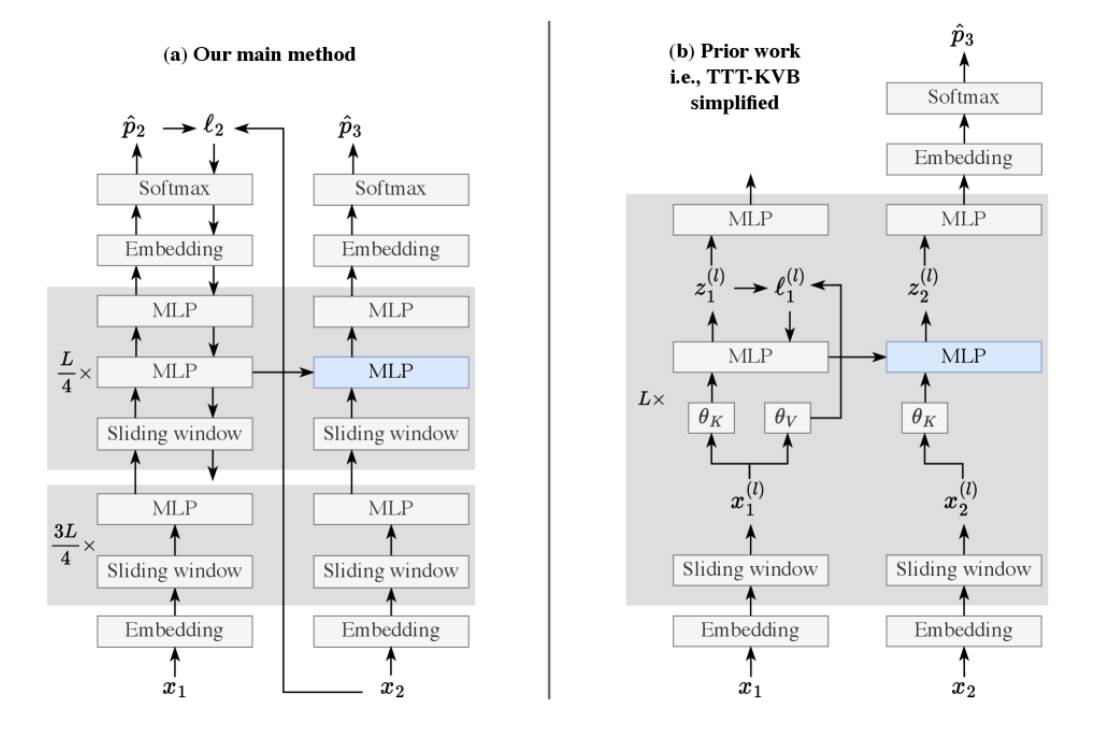
实际上就是以前的TTT是内部的memory使用内部的重建损失进行局部的优化,这篇工作将这种做法扩展到了使用全局的CE损失进行优化。每进入一个token,得到它对应的CE,然后直接进行梯度传播,将MLP的权重进行动态更新,以此作为一种将上下文直接压缩到权重的方法。实际上为了梯度稳定和计算效率是每个chunk更新一次,而且这个chunk还是挺大的,有1k之长。另外为了减少计算开销只有后部的1/4层参与了TTT的计算,并且为了绕开持续学习的问题,在参与TTT的层中每个层都叠了两个MLP,以保证安全的commonsense。整体来说是一个在SWA的基础上使用TTT附加全局视野的工作,实验效果(尤其是NIAH)和GDN差不多。
9. Nested Learning
标题:Nested Learning: The Illusion of Deep Learning Architectures
概览:还是google的TTT的文章。前面三十多页全是一些变体,具体的架构放在最后面。这篇文章中最后使用的架构是一层self-referential Titans后接多层MLP,其中每层MLP设置了不同的更新频率。所谓的self-referential Titans就是标准的linear attention架构,但是qkv和两个门的变换权重全部使用在线更新的权重,美其名曰能够将上下文的信息融入qkv,避免shortconv造成的短视,但实际上还是把L2Norm和shortconv加上了,有点难绷。所有权重都使用delta规则进行更新,不过稍有不同,准确来说是基于delta的梯度下降。所有的memory依旧还是两层带残差的MLP。
10. Attention Sink and Head Collapse
标题:Attention Sink Forges Native MoE in Attention Layers: Sink-Aware Training to Address Head Collapse
概览:讨论 attention sink 及其解决方式的文章。前情提要,attention sink 的概念最早出现在 StreamingLLM 中,指的是 LLM 在部分 head 中将所有注意力集中到开头的 prefix token,并将这些 token 的语义置空,从而实现无输出的行为。attention sink 会导致额外的量化难度;这篇文章中还提到,attention sink 会导致模型的表达能力受限。文中展示了简单的可视化和推理:如果一个 head 想要将注意力集中到第一个 token,那后续所有的 query 都必须与第一个 token 的 key 相似,同时后续所有的 key 都必须与第一个 token 的 key 保持距离。这实际上限制了 query 和 key 的分布情况。而在采用额外的手段消除 attention sink 的模型中(文中用的是 GPT-OSS 和 Qwen3-Next),query 和 key 的分布则会更加多样化。
现有的消除 attention sink 的方法本质上都是直接赋予模型“无关注”的能力,从而不需要使用如此极端的行为来实现无输出。一种是经典的 output gating,在 neurips best paper 上亦有记载;另一种是 GPT-OSS 的模式,即在 softmax 的分母中添加一个额外的可训练 sink 项,从而破坏总和为 1 的约定。文中证明这本质上也是一种 output gating。
output gating 实质上可以成为一种衡量 head 贡献的指标,文中的后半部分都在利用这一点设计。所谓的 head collapse 指的是只有少数的、固定的 head 对生成结果有活跃的贡献,类似于 MoE 中的 expert collapse/共享专家现象。一般地来说,这种现象被用于剪枝或者轻量化设计,比如 DuoAttention 只对重要的 head 使用了 full attention。这篇文章反其道而行之,设计了一个辅助 loss 用于鼓励 head 之间的均衡利用,并成功地通过这种 loss 设计获得普遍的性能提升。
值得注意的是,这里提到的 output gating 与 delta 风格的 gating 还是有一些不同的。这里的 output gating 对于每一个 head 是一个标量,linear attention 中常见的 gating 是一个更细粒度的向量。
11. Test-Time Training with KV Binding Is Secretly Linear Attention
标题:如题
概览:震撼首发,来自 NVIDIA 的作品。现存的 TTT 包括两种风格,一种与 Linear Attention 类似,loss 优化的对象是内部的 key-value binding,只不过通常使用更复杂的 memory 结构和更复杂的优化器;另一种直接以输出损失为目标进行全局的反向传播(E2E),如上文的 E2E-TTT。KVB 模式下,核心的 update 规则通常被视为一个在线学习问题,即 memory 压缩了 key 到 value 的映射,query 去查询结果。这篇文章通过四个实验证明这个视角实践中可能并不有效:
-
增加 inner loop 的轮数,KVB loss 降低,但是全局 ppl 上升。这里的增加轮数并没有说怎么个增加法,应该就是把在线 SGD 的步数从 1 调整到更多。这证明内部 loss 并不能代表全局的性能表现。不过,这不能避免是 OOD 带来的问题。
-
把在线 SGD 的梯度符号取反,不会改变输出的质量。这就比较能说明问题,因为这样的作法实际上已经是在劣化内部损失,但是对输出还是没什么影响。
-
KVB 中的 Q 和 K 分布并不统一,V 和 O 的分布也不统一。
-
把 Q 直接换成 K 对结果也没有什么很大的影响。这一点比较疑惑,它想表达的意思应该是如果 Q 真的是一个合法的 query,那么输出的东西就很大程度上依赖于查询了什么;如果我把查询的东西都换了,那应该会形成相当大的扰动。但这种事并没有发生,所以 Q “does not function as a meaningful query into a memorized key-value map”。
所以在 KVB 范式下,在线学习的说法似乎并不奏效,那么由此出发进行的各种优化器替换、网络结构设计可能也并不怎么奏效。
文中另外指出了,大多数的 KVB 模式都可以被写成广义的 linear attention。核心的思路是把 MLP 的最后一个 Linear 抽出来,它的更新自然会成为一种类 Hebb 的形式(参见 Nested Learning 中关于[Optimizer as Associative Memory](Optimizer as Associative Memory – 风起地)的推导)。而在它之前的层被视为 linear mapping 之后产生的 q 和 k 经过的 feature mapping kernel,将它们映射到真正写入最后一层的 memory 中时使用的 q 和 k。考虑到这些层都是 fast weight,那么这些层可以被看作在学习一个 dynamic kernel。如下。
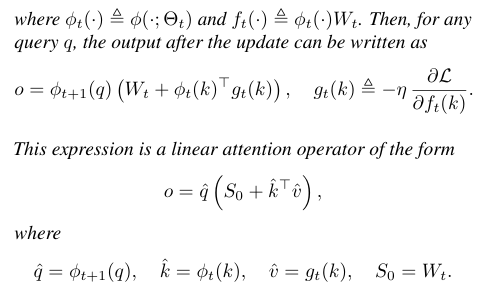
在这个视角下,一些现象可以得到相当程度的解释:
-
KVB MLP 不仅包括了 memory 的动力学,还包括了 q 和 k 的 feature kernel。所以强行增加迭代轮数也会改变 kernel 的行为,这会导致 train-test mismatch。尽管 loss 确实下降了。
-
梯度符号取反。它只是改变了 value 的符号而已,而不是真的使某个 loss 在飞速上升。
-
在 KVB MLP 之前取得的 q 和 k 还不是真正写入 memory 时使用的 q 和 k,它们分别还要经过由 MLP 主导的 feature mapping。因此,在 MLP 前取得的 q 和 k 还不在同一个特征空间中,它们之间的分布不匹配是可以理解的。
-
同上,即使把 q 换成 k,因为 query 和 key 分别经过了不同的 feature mapping,对于真正输入 memory 时使用的东西,它们也未必是一样的。这可能不是特别的有说服力,作者似乎认为 这样的自相关不能形成有效的注意力。
换言之,这篇文章事实上在暗示一个观点:一个多层 MLP 作为 memory 的 TTT 模型在实际训练中并没有把整个 MLP 作为 memory 的行为,反而更像是学习了一个 feature mapping 和一个单层的 linear memory。storage-and-retrieval 的行为在整个 MLP 的尺度上不生效,但在把 MLP 拆分成 feature mapping 和 memory 的视角下应该生效,尽管它还并没有验证这一点,比如输入 memory 时的 q 和 k 是否同分布。但文章在后续的实验中进一步支持了这个假设。它的实验意在以 linear attention 的视角,将 TTT 模型(LaCT)逐步简化成 linear attention。它的简化相当地大刀阔斧,最后几乎就是简化成了一个朴素的 linear attention,甚至连 per-token lr 都去掉了。不过,最有趣的简化在于第一步:只把 MLP 的最后一层保留为 fast weight,feature mapping 设置为静态权重,性能相比原始的 LaCT 不降反升。不过,这里仍然保留了 weight normalization、momentum 和 muon gradient orthogonalization 一类的操作。作者尽管认为这些东西理论上不是很必要,但是去除之后确实引起了一定的性能下降,只能看作是性能换 throughput 的操作。
另外,文中实验用的 LLM 是 780M 100B token 规模的。只看了 ppl,其实并不能验证在长文本特定的任务上是否有影响。
12. mHC
标题:mHC:Manifold-Constrained Hyper-Connections
概览:也算是轰动一时的文章了,我们只关心数学原理,不关心 infra 的优化。HC 的基本元素可以参考这篇知乎文章。简单来说,原始的残差流被扩大为原来的 n 倍,用于承载更加泛化的残差信息。在这个视角下,每一个 layer 所做的事情实际上是:将 n 个残差流的信息提取到一个流中,进行处理,然后再写回到 n 个残差流中。提取和写回的过程均由权重控制。另外,每经过一个 layer,HC 就允许 n to n 的信息交换,这也由权重控制。这里虽然说是权重,但实际上都是 input-dependent 的。
mHC 动手脚的地方在于最后一块,因为 n to n 的信息交换由权重控制,实际上就是有多层累乘之后消失或者爆炸的风险。mHC 选择对这个最后这个权重进行约束,从而避免这种问题。他们的选择是约束为双随机矩阵;所谓双随机矩阵,就是每一行和每一列的元素之和都为 1, 并且元素均非负的矩阵。Birkhoff-von Neumann 定理决定了任意一个双随机矩阵都能够分解为排列矩阵的线性组合,因此这种约束下,实际上行为就是对 n 个流进行多种重排,然后将它们混合起来。另外,双随机矩阵的谱范数不大于 1,因此不会发生爆炸的行为(但是这并不能保证没有消失的行为)。
至于如何获得这个,文中的实现是在原本的基础上进行 Sinkhorn-Knopp 迭代,实际上就是对交替地进行列的 normalization 和行的 normalization,直到收敛为止。文中选择迭代了 20 次。
不过,正如上方引用的知乎文章所言,这个矩阵本身的存在必要性是有些可疑的。换句话说,流与流之间是否真的需要主动重排和混合,这并没有明显的证据。甚至直接将它设置为单位矩阵可能效果还更好。
13. suRNN
标题:Efficient Sparse Selective-Update RNNs for Long-Range Sequence Modeling
概览:自动化所出品,做的其实非常简单。原始的一般的 RNN 形式是
这篇文章所做的唯一改动就是
其中是一个逐神经元的二值门控,视为点积或者对角阵都是可以的。这种设计实际上就是为了在冗余的长序列下,保持一定可能性的无更新行为。在无更新的同时,衰减也不发生,因此梯度传播中的消失和爆炸也不再与序列长度直接相关,而是与门控开启的次数相关。本质上,这就是一种使用选择性更新缓解梯度问题的措施。
这里顺带一提,现代的 linear attention 很少再提到所谓梯度消失的问题,是因为 delta/hebb 规则和 qk normalization 已经保证了梯度的稳定性。如下:
\begin{align}
S_{t}&=S_{t-1}A_{t}+B_{t}. \\
\frac{\partial{\mathcal{L}}}{\partial{S_{t-1}}}&=\frac{\partial \mathcal{L}}{\partial S_{t}} \frac{\partial{S_{t}}}{\partial S_{t-1}}+\frac{\partial{\mathcal{L}}}{\partial{o_{t}}} \frac{\partial{o_{t}}}{\partial{S_{t-1}}}\\
&=\frac{\partial \mathcal{L}}{\partial S_{t}}A_{t}^T+\frac{\partial{\mathcal{L}}}{\partial{o_{t}}}q_{t}^T.
\end{align}
剩下的部分详见苏剑林对EFLA的写法。他所讨论的是前向的累乘为何不会导致数值的坍缩或者爆炸,结论是 delta 转移矩阵所有的特征值均为 1,除了。而 k norm 保证了后者不会飞起来。前向和反向的稳定性是相似的,事实上线性演化的前向和反向形式高度相似,前向的稳定性实际上也保证了反向的稳定性。
还有一点不同的地方是门的决定,它的门的决定是借由一个三角震荡发生器引起的(可能有些类似 CPG),并将震荡发生器产生的值通过阶跃函数,通过 STE 或者代理函数进行反向传播。震荡的频率和相位等是可学习的参数。这个设计选择并没有被解释,或许是为了周期性地对门进行激活。
中间理论分析的都是比较直观的结果,多少有点复杂化了。实验结果有点乱。related work 里面有一些其他相关的东西。
14. Attention Matching
标题:Fast KV Compaction via Attention Matching
概览:KV Compression/Compaction,暂译为 KV 压缩/紧致化,似乎是一种比较新的内存管理策略。上一次看类似的东西还是在 dynamic sparse 主导的时期,历史上 KV 轻量化大致包含两种策略,一种是在实体上仍然保留全部的 KV Cache,但是在计算 attention 时只取其中的一部分,比如 deepseek 的 NSA 和后续的 lightning indexer。另一种是动态地将一些 token 永久性地删除,比如一些 token 驱逐和融合的策略(虽然没怎么看过)。这些方法某种意义上还是“明文”的,explicit 的方法,因为它们仍然是以单个 token 为最小单位对 cache 进行管理。KV Compaction 的核心是从隐空间的视角来解决这个问题,即能否重新寻找一组更短的 KV,使得 attention 的输出与原来达到相似的效果?
从数学上来描述,就是找到一组替换原始的,使得对于后续追加的任意,以及任意的,都近似有:(应该要转置的,但是懒得打了,原谅我吧.jpg)
attention matching 求解时多次利用了 landmark attention 中的原理,之前我将其称之为分层 softmax,它在这里进行了更简洁的表述:总体的 softmax 的结果,等价于每一个小块 softmax 各自 softmax 的结果,然后用每一个块的注意力质量(attention mass)再次加权。注意力质量的定义为,即注意力的分母。将分层原理应用到上面的条件上,我们得到了应该满足的条件:
\begin{align}
\text{Attention}(q,K,V)&\approx \text{Attention}(q,C_{k},C_{v}), \\
\text{Mass}(q,K)&\approx \text{Mass}(q,C_{k}).
\end{align}
这个写法将不确定的任意追加后缀从条件中排除了。然而,要让这两个式子近似成立还是太困难了,例如当时,这两个式子是完全不能成立的。因此,attention matching 附加了类似 ALiBi 的偏置,即。然后,通过求解来让以上条件近似成立。
在求解之前,我们应该明确在什么样的范围上进行求解。attention matching 作用的尺度不是 dynamic sparse/eviction 类似的尺度,即不是每生成一个 token 运行一次。例如,在 prefill 结束之后,attention matching 可以在 prefill 产生的 KV cache 上运行一次,然后使用压缩后的结果替换原本的 kv cache,再进行 decoding。attention matching 也允许二次压缩。换言之,具体在什么范围的上求解以上问题,是比较灵活的。
对于的范围,虽然原则上需要在任意的范围上成立,但实际上只在一组采样得到的上进行求解。文中对于采样的方法进行了讨论,总之就是使用一些特定格式的 prompt,然后采集 response 中的 query。采集是 on-policy 的,即在前序的层完成 compaction 之后才对后续的层进行采样,避免分布上的漂移。
attention matching 在求解时使用的是依次求解的方式,首先求解的是和,然后是。已知的情况下,利用。这是一个关于的线性方程,对于中的每一个 query,得到联立的线性方程组,从而求解得到。文中求解的方法是 NNLS,是一种迭代式方法,附录中对于 torch 的其他求解方法有讨论。利用第一个条件,可以写出关于的类似的方程,此处略过。
更困难的是的求解。文中限制了是的子集,即在 key 的构造上仍然是一种 token selection。那么,一种很自然的方法就是使用类似 sparse attention 的指标:在上计算所有 key 得到的 attention score,取其中 score 最高的子集。聚合来自不同的 query 的 score 的方式也比较特别,使用的是 RMS。只是一种经验上的选择。另一种更细致一点的求法是采用了 orthogonal matching pursuit (OMP) 的方法,总体来说是一种在 attention mass 上进行贪婪求解的方式。记,是逐行求和得到的目标 attention mass(真值)。由于限制了仍然是的子集,所以相当于从中挑选一些列。我们另外允许了 attention bias,所以优化的目标是
文中跳过了一些推导,这里补充一下。OMP 的求法是在当前的的基础上,贪婪地挑选一个新的 key,使得以上的 residual 最小化。然后固定,用 NNLS 求解当前最优的,如此交替求解,直到选满规定的预算为止。假设当前的 residual 是,那么下一个被挑选的 key 是
\begin{align}
k&=\arg \max_{\phi} ||m-\begin{bmatrix}
\Phi_{:,S} & \phi
\end{bmatrix} \begin{bmatrix}
w \\
w_{0}
\end{bmatrix}||_{2}^2 \\
&=\arg \max_{\phi}||m-\Phi_{{:,S}}w-w_{0}\phi||_{2}^2 \\
&=\arg \max_{{\phi}}||r-w_{0}\phi||_{2}^2 \\
&=\arg \max_{\phi}(||r||^2-2w_{0}r^T\phi+w_{0}^2||\phi||^2) \\
&=\arg \min_{{\phi}}r^T\phi.
\end{align}
以上是个人的推导,纯属猜测。也有可能是 OMP 里面本身有一些推导。
最后是关于非均衡的 KV 预算分配。attention matching 是一种 ad-hoc 的方法,由于每个 head 对长距离的依赖并不相同,所以它们也不应该分配相同的 KV 预算。文中使用了这样一种方式衡量 head 对 KV 预算的敏感性:先以同样的压缩比限制每一个 head,然后对一个单独的 head 加剧或者放松压缩,观察输出 loss 的变化。有一些 head 在放松约束之后并不会带来 loss 的下降,可见 KV 预算对它们来说没什么影响;有一些 head 则在更宽松的 KV 预算下可以显著降低 loss。
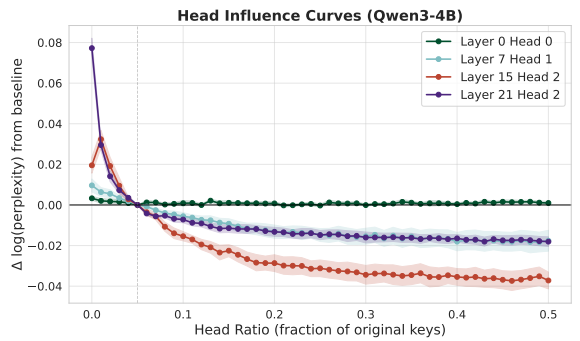
文中利用以上的曲线对特定的模型预计算预算分配方案。具体来说就是在一层中先假设均匀的预算分配,然后一次迭代中将某一个 head 的预算移动一部分到另一个 head 中,使得 loss 上的增益最大化。迭代到停止为止。
就结果而言,OMP 和朴素的选择策略表现相当,前者会好一点。full cache > latent compaction > sparse/eviction > 明文管理(summarization)。
15. Spiking Manifesto
标题:如上
概览:标题惊人,作者是 Izhikevich,即 Izhikevich neuron 的提出者。这篇文章的内容是对所谓脉冲神经网络(亦或传统的神经网络)的完全重构。在传统的神经网络中,如果要赋予其物理意义,网络中流动的激活值指的是发放频率,这样才能解释它和权重相乘的行为(当然只有在传统的网络结构中才能这样理解)。这篇文章的核心思想是,spiking 的计算本质特征在于利用时间维度,即延时形成的编码空间,而不是更具体的神经元动力学。只要保持延迟编码的特征,我们可以将具体的神经元抽象化,从网络中去除,从而利用上 hardware lottery 的红利。从计算开销的角度来看,传统的网络解读方式决定了激活值与参数(权重)的交互方式是以点积和 VMM 为主的稠密操作。这篇文章说明,从延迟的角度重新构建激活值与参数之间的交互方式,能够自然地形成 LUT 这样的稀疏操作。
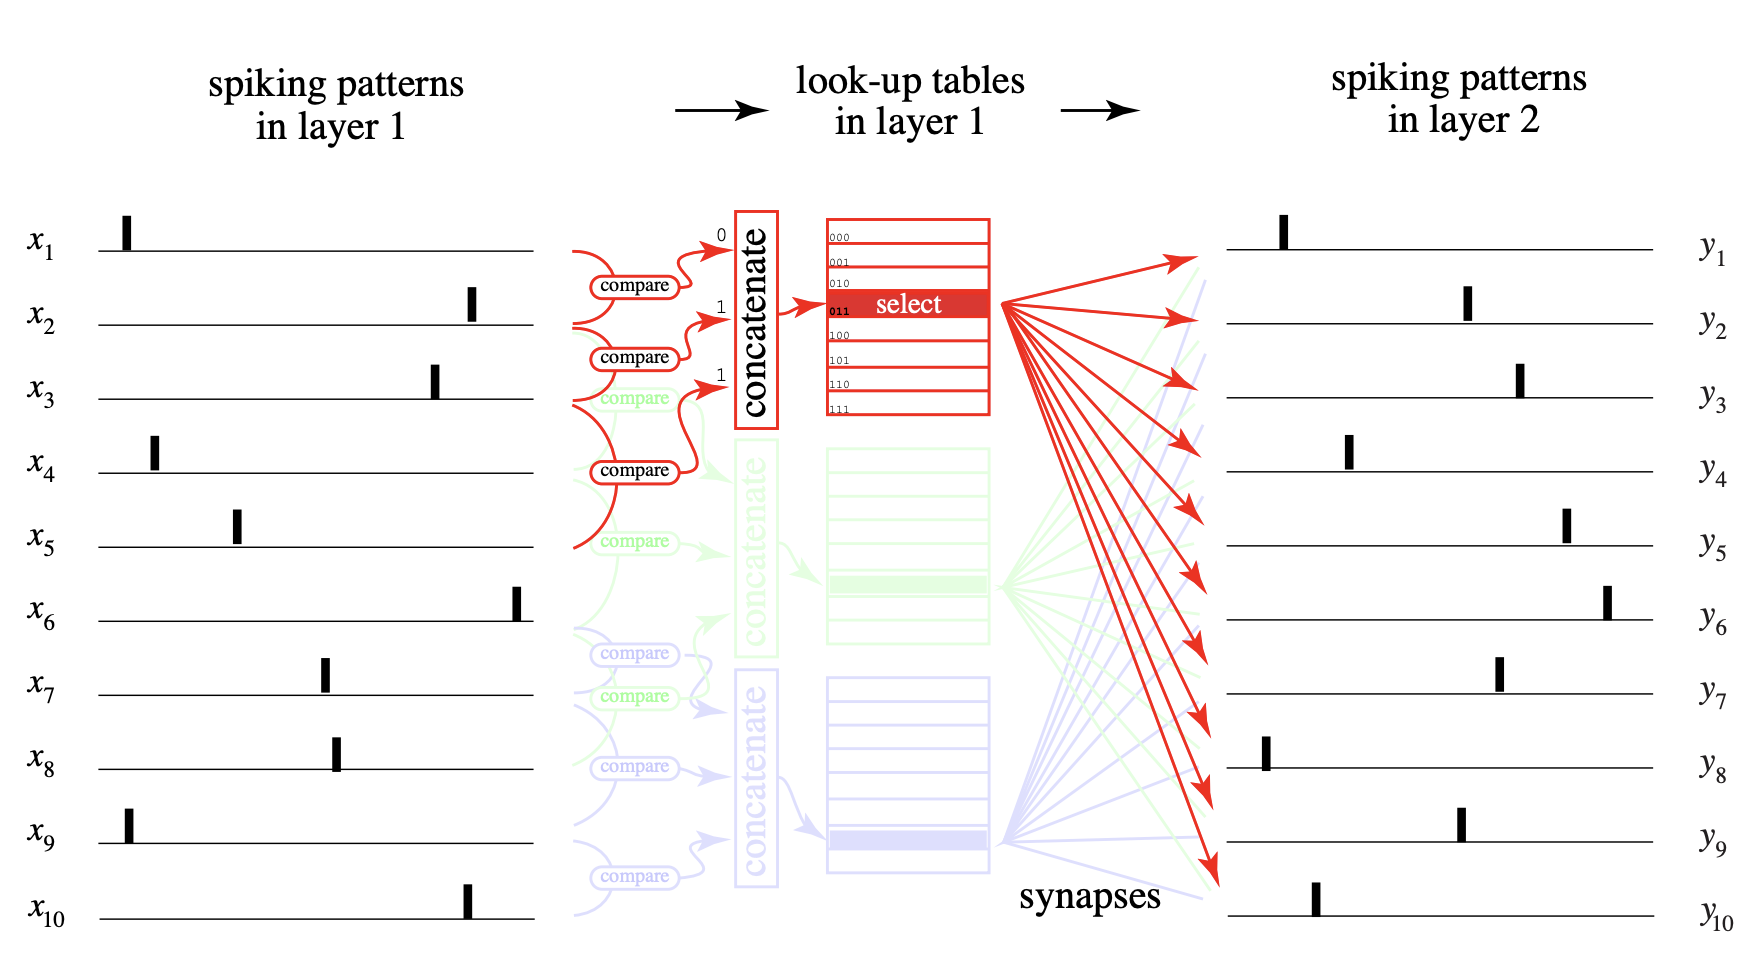
具体而言,一个网络中流动的向量的含义中,代表某一个脉冲的延迟,而不是发放率。注意到这里利用的是单脉冲编码,或者说 TTFS。从一个层传递到下一层时,交互方式如上图。具体来说,
-
一个层由个查找表(LUT)构成。LUT 有个 entry,这代表着个二进制位。相应地,每个 LUT 被分配了对的输入神经元。
-
输入到达时,对于每一个 LUT,对于每一个输入神经元对,比较它们之间的延迟,并使用一个二进制位来表达其结果。
-
每个 LUT 的个二进制位联合起来,指定了 LUT 的某一个 entry。这个 entry 中存储的内容就是这个 LUT 的输出。换言之,LUT 中存储的是所有可能的脉冲发放先后顺序情形下,该层输出的延迟分布情况。这实际上就是对脉冲神经元层的高度抽象;事实上,从上图左侧的脉冲分布变换到右侧的脉冲分布,可能经过了繁杂的网络处理。但是在这里,我们使用 LUT 中的权重直接学习了它的结果,跳过了具体的过程。
-
每个 LUT 分配到不同的输入神经元对,它们的输出求和,得到最终的层输出。
区别于一般的线性层,文中将这样的一层称为查找变换(look-up transformation),简记为
这样的结构当然也是不可微的,有类似 SNN 的梯度问题。它采用了类似代理梯度的方式。对于每一张表,查看所有的神经元对,找到两个神经元发放时间差距最小的那一对。它们是最容易发生时序翻转,从而导致输出结果变化的。如果它们之间发放时刻完全相同,那么其实不能确定输出需要取哪一个 entry。我们将这件事情概率化,此时应当各有 50% 的概率取到某两个 entry。进行一个概念性的推广,就可以推测这两个神经元的发放时间越近,反转到另一侧的情况的概率就越高;最高就是 50%。用一个替代概率密度曲线描述这个行为,将他作为替代梯度。实际上就是在反向传播的时候,将最容易发生反转的这个阶跃边界进行了平滑处理。每一张 LUT 都只会向这样一对发放时间间隔最近的神经元传播自己梯度。
文中还用类似的方式实现了 attention。一种朴素的方法是,将任意两对输入向量直接拼接起来,形成,使用这个合并向量去查表。每个 head 有一个独立的 LUT。这样做会带来平方的开销(LUT 的开销主要指的是计算索引的过程,而不是取出 LUT entry 的过程;有了索引之后,取出 entry 是很容易的)。所以它还提供了一种更轻量化的解决方式:对所有的预先计算出一个索引,然后使用合并的索引去找出最终的输出。它的用词是"concatenate the cached indices",这似乎在说有一张更大的表。具体细节不清楚,但大致的思想是这样。
实验部分展现出了非常特殊的优势,即快速的收敛。这种基于延迟的网络收敛的速度比传统的 Transformer 快上很多。它没有给出一个最终的性能对比,vision Transformer 的参数量是 806M。这个数看着很大,但是考虑到 LUT 实际上是高度稀疏的激活,实际激活参数量应该没有这么大。
Comments NOTHING