


Chapter 1: Probabilistic Reasoning
概率记号
概率表示中存在很多公认的缩写或者记号变体。比如:
- $p(c)$和$p(x=c)$是一个意思。
- 以一个随机变量作为求和下标(积分变量),指的是遍历它可能取到的所有状态。比如$\sum_x p(x):=\sum_{\texttt{x}\in dom(x)} p(x=\texttt{x})$。
- 联合分布$p(x, y):=p(x=a, y=b)$实际上是$p(x=a\text{ and }y=b)$的简写。后者事实上也是一个简写,指的是$p(e):=p(e=\text{True})$,其中$e$指代某一个事件。
- 集合论记法下,有$p(x,y):=p(x\cap y)$,$p(x\text{ or }y):=p(x\cup y)$。
- 贝叶斯公式是直接从条件概率的定义中得到的,所以这两者是可以互相替换称呼的。
- 离散变量的分布概率和连续变量的概率密度函数可能会混用,即$p(x)$和$f(x)$。同理,积分和求和会被混用,以对连续和离散的变量产生统一的表示,即$\int_x f(x)$和$\sum_x p(x)$。
“概率”本身的概念是有争议的,但是相比讨论概率的定义本身,讨论如何解读概率规则的含义可能更重要。概率规则(归一化,边缘概率的定义,条件概率的定义/贝叶斯公式)本身应该被看作符合直觉的数学表达,它们可以从很多角度出发被解读。
传统的频率学派可以从无限次实验的频率中解释概率,但是在很多机器学习的场景下,这种解释并不实用。例如,要基于用户对少数几部电影的评价,预测他对其他 10000 部电影的喜好。按照频率学派的解释,将电影划分成几个类别,我们仅有该用户的少量样本,没有条件进行“无限次”的实验。
This degree of belief or Bayesian subjective interpretation of probability sidesteps non-repeatability issues – it’s just a framework for manipulating real values consistent with our intuition about probability[159].
条件、独立和依赖
条件并不意味着因果关系。$p(A=a|B=b)$并不是“在事件$B=b$发生之后,事件$A=a$发生的概率”,因为这种描述暗含了两件事情发生的先后顺序,但实际上条件概率并没有要求这样的先后顺序。条件概率应该被理解为一种约束,即“在$B$处于$b$状态的约束下,$A$处于$a$状态的概率”。
独立(independent)并不意味着无关(irrelevant),在 P10 下方举了一个例子,直觉上相关的两个变量可能在概率上独立。独立应该被理解成一种附加信息,即“知晓$y$目前的状态,是否会影响到我对$x$的分布的判断”,即$p(x|y=\text{c})=p(x)?$。
条件独立的定义是 $p(x, y|z)=p(x|z)p(y|z)$,这里指的是 $z$ 取任意合法值时都要成立。它的含义是在某一个变量 $z$ 确定的情况下,知晓 $x$ 的状态不再能提供更多关于 $y$ 的信息。关于它的解读,在后续贝叶斯网络中出现。
独立和依赖均没有传递性。
贝叶斯推断
看看 Example 1.3 和 Example 1.5 就知道了。
关于贝叶斯公式的机器学习解读在 1.3,以及举的一个钟摆的例子。
open: Exercise 1.9,其原型为末日论证。
Chapter 3. Belief Networks
贝叶斯网络的定义
对于含有一堆变量的推断问题,最理想的情况就是我们知道它的联合分布,这样我们理论上能够知道任何条件下的各类条件分布和边缘分布。但这是不现实的,对于 N 个没有限制的二值变量,使用打表的方式写出它们的联合分布需要指数的空间。另外边缘化的开销也是不现实的,对于 N 个无限制的变量,为了得到其中一个变量的边缘分布就需要对其他所有变量进行积分。
为了简化这种情形,需要凭借经验(常识/先验知识)做出某些变量之间相互独立的假设,这样可以减小推断中积分所需要的计算开销和描述联合分布需要的空间。信念网络/贝叶斯网络/信念贝叶斯网络是描述变量之间独立关系的图结构。
观察到联合分布可以写成以下形式:
$$
p(x_1, x_2, x_3, x_4)=p(x_1|x_2,x_3,x_4)p(x_2|x_3,x_4)p(x_3,|x_4)p(x_4)
$$
假如 $x_1$ 和 $x_3$ 独立,则 $p(x_1|x_2, x_3, x_4)=p(x_1|x_2, x_4)$,条件里面就少了一项;如果通过打表来描述这个分布,就少了一些需要的空间。
给定$D$个变量,信念网络指的是如下形式的联合分布
$$
p(x_1,...,x_D)=\prod_{i=1}^D p(x_i|\text{pa}(x_i))
$$
除了$\text{pa}(x_i)$以外的节点,其他变量都与 $x_i$ 独立。信念网络可以等价地使用一个有向无环图表示。理论上,通过将联合分布拆解成条件分布的乘积,任何分布都可以写成贝叶斯网络的形式。
信念网络只指定了独立关系,没有对应一个具体的数值分布。由于拆解成条件分布的顺序是任意的,所以一组独立假设可以对应多个信念网络的图。
非确定证据与不可信证据
非确定证据(uncertain evidence/soft evidence)指的是作为证据的观察有一定的不确定性。比如,“听见了铃响”是一个确定性的证据(确定该事件在 True 的状态),“有 70% 确定听见了铃响”是非确定的证据(不确定事件是在 True 还是 False 状态,但有一定的概率分布)。
在使用非确定证据的推断中,“非确定证据的发生”仍然可以被记作一个事件 $\tilde{y}$ 来表示,它所对应的确信程度分布被记为 $p(y|\tilde{y})$ ,比如 $p(y=\text{True}|\tilde{y})=0.7$。作为对比,确定性的证据就是 $y=\text{True}$ 。另外,应该有 $p(x|y, \tilde{y})=p(x|y)$,所以推断的过程为
$$
p(x|\tilde{y})=\sum_y p(x,y|\tilde{y})=\sum_y p(x|y, \tilde{y})p(y|\tilde{y})=\sum_y p(x|y)p(y|\tilde{y}).
$$
事实上这是很直观的。实际上就是以证据处在各种状态的概率 $p(y|\tilde{y})$ 为权重,平均了各种情况下的概率。
不可信证据(unreliable evidence)指的是尽管观察者认为有一个确定性的证据发生,但是执行推断的人认为这个证据并不可信。比如,观察者认为观察到了 $y=\text{True}$,但实际上可能认为这个观察没有那么可信,如果事件$A$发生了,我们有 80% 的把握认为这个证据确实出现了,但如果事件$A$没有出现,我们有 20% 的把握认为这个证据出现了。我们描述的实际上是:我们不相信原本的 $p(Y|A)$,而是用我们的 $p(H|A)$ 去替代他。
贝叶斯网络的性质
尽管贝叶斯网络在图的形式上用边表示了直觉上的“依赖”关系,但是贝叶斯网络在数学上刻画的是一组条件独立假设,而不是统计上的依赖关系。如 Remark 3.4 所说,即使是 $a\rightarrow b$ 这样的图,也能够构造出一个分布的实例,使得 $a$ 和 $b$ 在数学上独立(因为这个图实际上是全连接的,表示了任意的二元分布)。如果几个不同的贝叶斯网络最终表示的分布形式是相同的,那么实际上它们对应了同一组条件独立假设。
definition: 对贝叶斯网络中的某两个节点,对于他们之间的一条无向路径,如果路径上某一个节点两侧的边方向均指向这个节点,称这个节点为冲突点(collider)。
definition: 对于 $X,Y,Z$ 三个不相交的定点集,称 $X$ 和 $Y$ 被 $Z$ d-连接(d-connection),当且仅当在 $X$ 和 $Y$ 之间存在一条路径,这条路径上的所有节点满足
1. 若节点是冲突点,则它或者它的后继在 $Z$ 中;
2. 若节点不是冲突点,则它不在 $Z$ 中。
反之,称 $X$ 和 $Y$ 被 $Z$ d-分隔(d-separation),即 $X$ 和 $Y$ 之间的所有路径上都需要存在某一个节点,这个节点需要满足
1. 若节点是冲突点,则它和它的后继均不在 $Z$ 中;
2. 若节点不是冲突点,则它在 $Z$ 中。
theorem: 若 $X$ 和 $Y$ 被 $Z$ d-分隔,则在该网络能够表示的所有概率分布上,$X$ 和 $Y$ 以 $Z$ 为条件独立。
根据条件独立的性质,这也包括了 $X$ 的任意子集和 $Y$ 的任意子集在 $Z$ 上独立。
同样的结论在 d-连接上不成立,即在网络上 $X$ 和 $Y$ 被 $Z$ d-连接,不能代表在网络所表示的分布上 $X$ 与 $Y$ 在 $Z$ 上条件依赖。
definition: 马尔可夫等价(Markov equivalence):若两个贝叶斯网络表示同一组条件独立假设,则称这两个网络马尔可夫等价。
theorem: 马尔可夫等价判定。定义网络中的一个不忠实(immorality)为一个三元组 $(A, B, C)$,满足 $C$ 同时是 $A$ 和 $B$ 的直接后继,并且 $A$ 和 $B$ 不直接相连。定义网络的骨架(skeleton)为去除边的方向得到的无向图。两个网络马尔可夫等价,当且仅当它们有同样的骨架,并且有同样的不忠实集合。
“不忠实”是勉强翻译的,没有找到中译版本。它的定义在直观上就是未婚($A$ 和 $B$ 不直接相连)先育(他们有一个共同的直接后继)。
贝叶斯网络不能表达任意的条件独立假设集合,具有一定的表达能力限制。例如,在 $p(t_1, t_2, y_1, y_2)$ 中,假设 $t_1 \perp!!!\perp (t_2,y_2), t_2 \perp!!!\perp (t_1, y_1)$ 无法使用贝叶斯网络表示,因为它实际上需要双向的箭头:
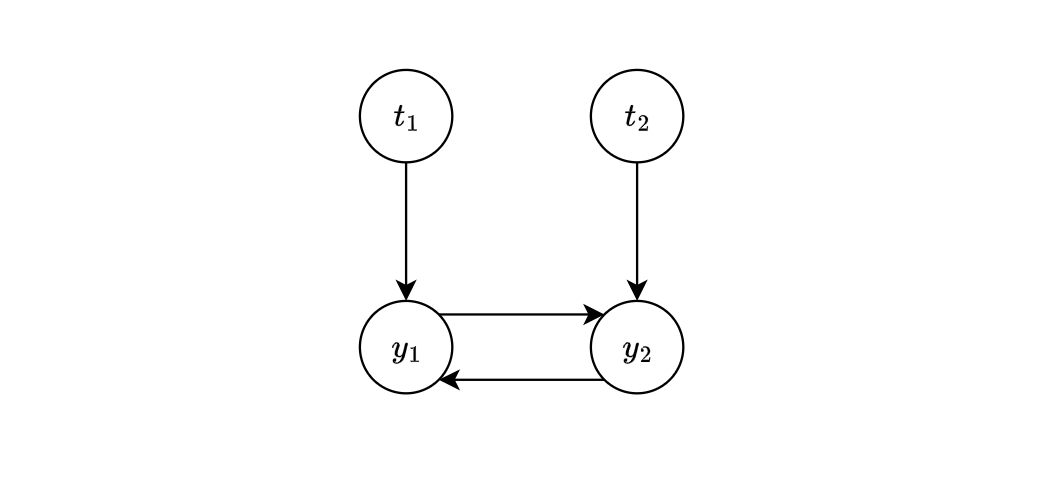
这使得它不再是一个 DAG。任何基于图的模型在表达独立性假设上都有一定的表达能力限制。
辛普森悖论(Simpson's paradox)
本节内容高度混乱,理解即可。在概率模型中,尤其是在贝叶斯网络中,图的表示法通常会在直觉上给出因果性的暗示,但是实际上并不是这样。原因是在条件概率中通常不考虑事情发生的先后顺序,在数学上表现为条件概率能够以任意的顺序分解,比如 $a\rightarrow b$ 和 $b\rightarrow a$ 实际上是马尔可夫等价的。有两条比较重要的陈述:
- 对于贝叶斯网络而言,在前文也提到过,贝叶斯网络只能表示独立假设,而非依赖。
- 对于统计模型而言,能够在形式上被推理的只有相关性(correlation)或者说依赖性(dependencies),而不是因果性(causality)。相关性与依赖性和因果性并不等价。
辛普森悖论是对后者的一个例子,亦见此处的例子。统计上,辛普森悖论是没有进行分层抽样的结果。从贝叶斯的角度,辛普森悖论是混淆了观察证据(observation evidence)和干预证据(intervention evidence)的结果,即出于人为的干预,联合分布不再能够写成级联式的条件概率展开,因为展开过程很可能与人为干预的因果关系不符(类比于高维分布采样的过程)。书上给了一个例子,用于说明如何修正联合分布使得推断能够得到正确的结果,但实在是太抽象了。
question: do-calculus
Chapter 4. Graphical Models(概率图模型)
包括贝叶斯网络在内,所有使用图的形式表达关于分布的假设并进行推理的模型统称为概率图模型。概率图模型的建立一般包括两个过程:
- 建模:做出关于联合分布的假设,并在图中表示。
- 推理:在建立的图上,计算出想要知道的概率值。
根据这两种用途,图模型大致分为两类,一类便于表示分布的假设,这一类包括贝叶斯网络,马尔可夫网络(Markov network)和链图(chain graph)等。令一类便于进行概率推理时的计算,这一类包括因子图(factor graph)和联结树(junction tree)等。
Markov network
definition:定义势函数(potential)为对于某一个随机变量的非负函数 $\Phi (x)\ge 0$ 。以此类推,联合势函数指对多个随机变量的非负函数。在这个视角下,一个分布就是满足标准化条件的势函数,即 $\int_x \Phi (x)=1$。
definition:对于 n 个变量 $X={x_1, ..., x_n}$,马尔可夫网络定义为在一系列的变量子集 $X_c\subseteq X,c=1,...,C$ 上的势函数乘积
$$
p(x_1,...,x_n)=\frac{1}{Z}\prod_{c=1}^C \Phi_c (X_c)
$$
马尔可夫网络在图的表示上为一个无向图,其中每一个变量子集 $X_c$ 中的变量节点在图中构成一个极大完全子图(团)。如果所有的势函数严格非零,该分布也称为吉布斯分布(Gibbs distribution)。如果极大完全子图的节点数量最多是 2(即一个势函数中最多包括两个变量),该分布也称为逐对马尔可夫网络。
马尔可夫网络的图表示可以认为是这样获得的:将每一个变量子集中的节点之间所有可能的边都加上。不同的马尔可夫网络可能对应同一个图表示,比如 $\Phi(x_1,x_2,x_3)\Phi(x_3,x_4)\Phi(x_4,x_5)$ 和 $\Phi(x_1,x_2)\Phi(x_2,x_3)\Phi(x_1,x_3)\Phi(x_3,x_4)\Phi(x_4,x_5)$ 将会对应同一个图表示。但是,后者实际上也可以被写成前者的形式,因此这个图唯一对应于 $\Phi(x_1,x_2,x_3)\Phi(x_3,x_4)\Phi(x_4,x_5)$ 这个形式,所有能够写成这个形式的分布都对应这张图,但是某些实例仍然能够被分解到更细的程度。
马尔可夫性质
与贝叶斯网络类似地,我们仍然关注从马尔可夫网络中能够得到哪些条件独立假设。
definition:对于两个不相交的节点子集 $A$ 和 $B$ ,如果任意从 $A$ 出发的路径都要经过 $S$ 才能到达 $B$,称 $S$ 在网络中分隔 $A$ 和 $B$。如果不存在从 $A$ 到 $B$ 的路径,那么认为 $A$ 和 $B$ 是互相分隔的,即使 $S=\Phi$。
theorem:全局马尔可夫性质。对于任意不相交的变量子集 $(A, B, S)$,如果 $S$ 在图上分隔 $A$ 和 $B$,则 $A\perp!!!\perp B|S$。
theorem:局部马尔可夫性质。对于吉布斯分布,有 $p(x|X\setminus x)=p(x|\text{ne}(x))$。ne 指的是邻居集合。
记 $A=\text{ne}(x)$,$B=X\setminus {A, x}$,局部马尔可夫性质说的实际上是
$$
\begin{aligned}
p(x|A, B)&=p(x|A),\
p(x,B|A)&=p(x|A)p(B|A),\
x&\perp!!!\perp B|A.
\end{aligned}
$$
即以邻居为条件时,一个变量与邻居以外的所有变量条件独立。
theorem:逐对马尔可夫性质。对于网络中任意两个不相邻的节点,有 $x\perp!!!\perp y|X\setminus {x,y}$。
以上三条统称马尔可夫性质。全局马尔可夫性质强于局部马尔可夫性质,局部马尔可夫性质强于逐对马尔可夫性质。但如果一个分布是吉布斯分布,则三者等价。(来自wiki)
definition:对于 n 个变量的分布,以变量为顶点构造任意的无向图 $G$。如果这个分布在 $G$ 上满足局部马尔可夫性质,则称该分布是在 $G$ 上的一个马尔可夫随机场(Markov Random Field,MRF)。如果该分布同时是一个吉布斯分布,则称该分布是 $G$ 上的一个吉布斯随机场(Gibbs Random Field)。
theorem:Hammersley-Clifford theorem。在一个无向图 $G$ 上,吉布斯分布的定义(联合分布能够分解成根据极大完全子图定义的乘积因子,且因子非零)与吉布斯随机场的定义(在图上满足局部马尔可夫性质)等价。
由于在吉布斯分布中,三个马尔可夫性质等价,所以实际上在后者中只需要满足三个马尔可夫性质中的任意一个即可。wiki 上给出了更严谨的表述:
It states that a probability distribution that has a strictly positive mass or density satisfies one of the Markov properties with respect to an undirected graph G if and only if it is a Gibbs random field, that is, its density can be factorized over the cliques (or complete subgraphs) of the graph.
Hammersley-Clifford theorem 是随机场论的基础。书上展示了一个实际的例子,这个例子也挺长的,这里就不写了。
4.2.4 节给出了贝叶斯网络和马尔可夫网络通用的判断条件独立的算法。有点长,这里不抄了。注释写在书上。
Lattice Model(晶格模型)
晶格模型是逐对马尔可夫网络的一种,其网络结构为经典的 Mesh 结构,且其中的变量均为 0/1 变量。其中包括著名的伊辛模型(Ising model):
$$
\Phi(x_i,x_j)=e^{-\frac{1}{2T}(x_i-x_j)^2}
$$
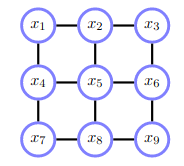
伊辛模型描述了物理上的磁学系统,其因子促使相近的变量保持在相同的状态。当温度 $T$ 较低时,所有的变量都趋向于保持在相同的状态,表现出宏观的磁性;在无限大的二维平面上,当温度超过居里温度时,磁性开始快速下降。本质上,它描述了一种由弱的局部约束导致的全局一致效应的过程,即所谓的涌现(emergent behavior)。
相似的思想被用于图像去噪。一般认为相近的像素点总是趋向于保持一致,而附加的噪音则没有这样的性质。
Chain Graphical Models(链图)
链图(Chain Graphs,CG)指的是同时含有有向边和无向边的图。
definition:在链图中去除所有的有向边,剩下的每个连通分量的节点集合称为链成分(Chain Component)。
definition:给定一个变量集合 $X$ 和相应的链图 $G$,找出链图的每一个链成分 $\tau$ 和对应的变量子集 $X_{\tau}$,链图对应的分布定义为
$$
\begin{aligned}
p(x)&=\prod_{\tau}p(X_\tau|\text{pa}(X_\tau)),\
p(X_\tau|\text{pa}(X_\tau))&=\prod_{d\in D_\tau}p(x_d|\text{pa}(x_d))\prod_{c\in C_\tau}\Phi(X_c).
\end{aligned}
$$
其中,$D_\tau$ 定义为链成分 $\tau$ 的节点集合,$C_\tau$ 定义为链成分 $\tau$ 对应的极大团集合。当所有的链成分均只包含一个节点时(即网络中没有无向边时),第二式第二项消失,网络退化为贝叶斯网络;当网络中没有有向边时,第二式第一项消失,网络退化为马尔可夫网络。
如定义所见,链图是贝叶斯网络和马尔可夫网络的结合。事实上,链图的表达能力强于贝叶斯网络和马尔可夫网络。
Factor Graphs(因子图)
definiton:因子图定义为如下的分布
$$
f(x_1,...,x_n)=\frac{1}{Z}\prod_i \psi_i(X_i)
$$
其中,$\psi_i$ 称为因子,在因子图中表示为方形的节点;与因子相连的变量节点形成的集合定义为 $X_i$。$\psi_i(X_i)$ 与链图中的定义相似。当使用的是无向边时,因子定义为 $\psi_i(X_i)=\phi(x_1, .., x_n)$ 这样的马尔可夫形式;当使用的是有向边时,因子定义为 $\prod_{d\in D_\tau}p(x_d|\text{pa}(x_d))$ 这样的贝叶斯形式,此时先驱节点指向目标的因子节点,因子节点再指向它的成员。
因子图贝叶斯网络和马尔可夫网络,能够保留更多的关于分布形式的信息。在马尔可夫网络以及图表示的定义中,我们提到过尽管一个无向图唯一确定一个因子分解形式,但具体的分布可能还能进一步分解。比如,$\phi(x_1, x_2)\phi(x_2, x_3)\phi(x_1, x_3)$ 在转换成图表示的过程中,实际上就会损失掉更细粒度的因子信息。因子图能够对这些信息进行保留,即区分 $\phi(x_1, x_2)\phi(x_2, x_3)\phi(x_1, x_3)$ 和 $\phi(x_1, x_2, x_3)$ 这两种形式。
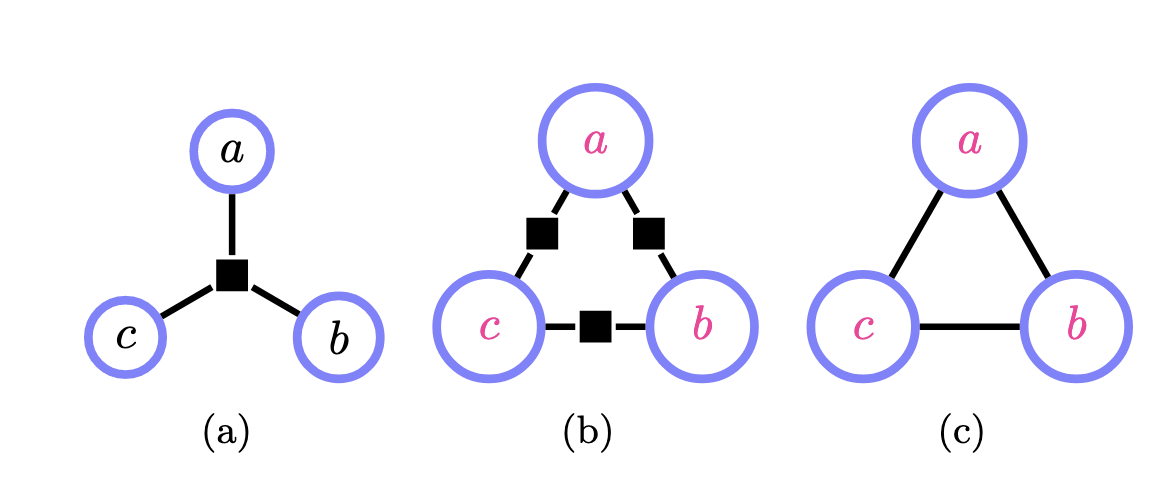
在因子图中,同样有条件独立判断的方法。
theorem:对于因子图中的两个变量和条件变量集合,如果所有连通两个变量的路径都被阻塞(blocked),则这两个变量条件独立。阻塞定义为一条路径至少满足以下条件中的一个:
- 路径上的某一个变量在条件变量集合中。
- 路径上存在一个变量节点或者因子节点,它两侧的边均为入边,且它和它的所有后继都不在条件变量集合中。
图模型的表达能力
definiton:对于一个图 $G$ 和一个分布 $P$ ,如果从 $G$ 中能够得到的条件独立假设在 $P$ 中均成立,那么称 $G$ 为 $P$ 的独立映射(independence map, I-MAP)。
反之,如果从 $P$ 中能够得到的条件独立假设在 $G$ 上均成立,那么称 $G$ 为 $P$ 的依赖映射(dependence map, D-MAP)。
如果 $G$ 既是 $P$ 的独立映射,又是 $P$ 的依赖映射,那么称 $G$ 为 $P$ 的完美映射(perfect map)。此时,图和分布本身对条件独立和条件依赖假设的表达能力一致。
任何一个贝叶斯网络都可以改写成马尔可夫的形式,因为 $p(a|b)=\phi(a, b)$。但这并不意味着马尔可夫网络的表达能力更强,因为在转换的过程中,一些条件独立假设可能会被丢失。
(Exercise) Boltzmann Machine / Restricted Boltzmann Machine
玻尔兹曼机原始的定义是
$$
$$
Comments NOTHING