Lec 1-2. Point Estimation
在统计学中,点估计(英语:point estimation)是指以样本数据来估计总体参数, 估计结果使用一个点的数值表示“最佳估计值”,因此称为点估计。由样本数据估计总体分布所含未知参数的真实值,所得到的值,称为估计值。
点估计关注的是通过部分的数据(发生的事件/一些从分布中得到的采样)估计完整的概率分布的问题。通常来说,这个未知的概率分布由一定的未知参数进行参数化,估计概率分布的问题即确定参数的过程。相对地,区间估计(interval estimation)指的是对未知参数确定一个区间,我们以一定的置信度认为参数应当在这个范围内。
最大似然估计(Maximum Likelihood Estimation,MLE)的原则是,将已发生的事件概率最大化的参数作为最优参数,从而将问题转换为一个优化问题。
在贝叶斯公式中:
P(θ∣D)=P(D)P(θ)P(D∣θ)
一种常见的解读是,P(θ∣D)为后验,即在给定的观测数据下,参数的分布;P(θ)为先验,即未给定观测数据时,设想的参数分布;P(D∣θ)为似然,即给定参数的情况下,某一组观测数据出现的概率。P(D)为归一化项。MLE 优化的对象即为P(D∣θ)。
如果先验分布与后验分布为相同形式的分布,则称这个先验分布和后验分布称为共轭分布。此时的先验分布称为似然函数P(D∣θ)的共轭先验(conjugate prior)。例如,beta分布是二项分布的共轭先验。共轭先验的主要用途是用于求得具有闭式解的后验分布;事实上,我们需要去寻找一个符合共轭先验条件的概率密度函数,从而使得后验具有闭式解。
与 MLE 相对地,最大后验估计(maximum a posteriori,MAP)最大化的对象是后验P(θ∣D)。与 MLE 相比,由于P(θ∣D)∝P(θ)P(D∣θ),MAP 实际上是在考虑了实验证据(似然)的基础上,又考虑了先验分布。
MAP 也可以视为一种期望的近似估计方法。假设我们在得到后验分布P(θ∣D)之后,我们要估计某一个量f(θ)的估计值,我们实际上需要求它的期望E[f(θ)]=∫f(θ)P(θ∣D)dθ。MAP 可以视为取了 θ^=argmaxP(θ∣D),然后取E[f(θ)]≈f(θ^)。
#todo
Latent Dirichlet Allocation
#todo
近似 Bayes 计算前沿研究进展及应用,approximate bayesian computation
MLE of Gaussian
Gaussian 的概率密度函数
f(x∣μ,σ)=√2πσ21exp(−2σ2(x−μ)2).
似然
p(D∣μ,σ)=(√2πσ21)Ni=1∏Nexp(−2σ2(xi−μ)2).
取其对数,不改变单调性:
lnp(D∣μ,σ)=−Nln(√2πσ21)i=1∑N2σ2(xi−μ)2.
分别对两个参数求其偏导,得到μ的 MLE 是数据的均值,σ的 MLE 是数据的方差。
对于 Gaussian 的 MAP 估计,σ的共轭先验是 Wishart Distribution,μ的共轭先验是 Gaussian 分布本身。
Regression Hypothesis & Bias-Variance Tradeoff
在求解回归问题中,必然在目标函数的求解空间中做出一定的假设。实际计算中,往往体现为在指定的函数族中参数化目标函数,从而将目标函数的求解转换为函数参数的优化问题。简化的求解空间可能会带来表达能力的损失,高度灵活的求解空间可能会带来过拟合的问题。在对于宏观规律的描述,而不是数据本身的拟合问题上,求解空间的复杂成本是一种权衡。
过拟合往往伴随着极大或者极小的参数和大幅度的震荡(e.g. 龙格现象),因此正则化/正规化(regularization)是一种常见的手段。
SVD 与特征分解
奇异值分解(Singular Value Decomposition)的定义:
对于一个矩阵X∈Rm×n,总是存在一个分解,使得
X=UΣV∗.
其中U∈Rm×m是正交矩阵(酉矩阵),其列向量称为X的左奇异向量。Σ∈Rm×n为非负实数构成的广义对角阵,其中的对角元称为奇异值。V∈Rn×n也是正交矩阵(酉矩阵),其列向量称为X的右奇异向量。显然,我们可以容易地通过一些缩放将左奇异向量和右奇异向量都变成单位向量,一般情况下我们也这样约定,使得Σ能够被唯一确定。在此约定下,若将对角线元素相同但排列顺序不同的Σ视为等价,则Σ由X唯一确定。一般情况下,我们将规定奇异值排列顺序为σ1≥σ2≥…≥σm≥0。注意到Σ实际上是对U的列向量缩放(或者对V的行向量缩放),SVD 分解存在迭代形式
X=UΣV∗=i=1∑min(m,n)σiuiviT.
Eckart-Young-Mirsky 定理:在一个矩阵的 SVD 分解D=UΣVT中,将Σ中的奇异值保留前k大的值,其他奇异值置零,得到Σ^,得到的矩阵D^=UΣ^V。或者使用求和形式,写成
D^=i=1∑kσiuiviT.
D^是以下问题的最优解:
D^min∣∣D−D^∣∣F,s.t. rank(D^)=k.
同时也是以下问题的最优解:
D^min∣∣D−D^∣∣2,s.t. rank(D^)=k.
且对于 Frobenius 范数,这个最小值是∑i=k+1min(m,n)σi2;对于二范数,这个最小值是σk+1。
证明(二范数下):由二范数的定义,
\begin{align}
||D-\hat{D}||_{2}&=||\sum_{i=1}^{\min(m, n)}\sigma_{i}u_{i}v_{i}^T-\sum_{i=1}^{k} \sigma_{i}u_{i}v_{i}^T||_{2} \\
&=||\sum_{i=k+1}^{\min(m,n)} \sigma_{i}u_{i}v_{i}^T ||_{2}=\sigma_{k+1}.
\end{align}
对于任意的秩为k的矩阵B∈Rm×n,取其零空间的一组基{x1,x2,…,xn−k}(回忆一下线性代数的基本知识:零空间指的是满足Bx=0的向量张成的空间,它的维度由秩-零化度定理决定,即零空间的维度加上像空间的维数等于目标空间的维数)。根据维数定理,{x1,x2,…,xn−k}张成的空间与{v1,v2,…,vk+1}张成的空间交不为空。在该空间中取出一单位向量z,则有Bz=0,同时由于所有的右奇异向量之间相互正交,z和{vk+2,…,vn}都正交。因此,
\begin{align}
Az&=\sum_{i=1}^{\min(m, n)}\sigma_{i}u_{i}v_{i}^Tz \\
&=\sum_{i=1}^{\min(m, n)}\sigma_{i}(v_{i}^Tz)u_{i} \\
&=\sum_{i=1}^{k+1}\sigma_{i}(v_{i}^Tz)u_{i}.
\end{align}
根据二范数的定义,得到
\begin{align}
||D-B||_{2}^2\geq ||(D-B)z||_{2}^2=||Dz||_{2}^2=\sum_{i=1}^{k+1} \sigma_{i}^2(v_{i}^Tz)^2\geq\sigma_{k+1}^2.
\end{align}
第二个等号成立的原因是ui都是单位向量(左奇异向量)。第二个等号成立的原因是∑i=1k+1(viTz)2=1(z是单位正交基{v1,v2,…,vk+1}张成的空间中的单位向量),并且奇异值是从大到小排列的。QED
让我们使用分块矩阵的形式写出D^的表达:
\begin{align}
\hat{D}&=\begin{pmatrix} U_{m,k} & U_{m, m-k} \end{pmatrix}
\begin{pmatrix}
\Sigma_{k,k} & 0_{k,n-k} \\
0_{m-k,k} & 0_{m-k,n-k}
\end{pmatrix}
\begin{pmatrix} V_{k,n}^T \\ V_{n-k,n}^T \end{pmatrix} \\
&=\begin{pmatrix} U_{m,k}\Sigma_{k,k} & 0_{m,n-k} \end{pmatrix}
\begin{pmatrix} V_{k,n}^T \\ V_{n-k,n}^T \end{pmatrix} \\
&=U_{m,k}\Sigma_{k,k}V_{k,n}^T.
\end{align}
这种形式被称为截断 SVD(Truncated SVD)。我们将它记为D^=UkΣkVkT。其中,Σk∈Rk×k是由前k大的奇异值构成的对角矩阵;Uk∈Rm×k是由前k大的奇异值对应的左奇异向量构成的矩阵;Vk∈Rk×n是由前k大的奇异值对应的右奇异向量构成的矩阵。
Eckart-Young-Mirsky 定理保证了 SVD 可以用于特征分解。想象这样一个场景:我们有一组数据Y∈RN×d,我们希望使用少量的特征数据W∈Rp×d,以及使用这p个特征之间的线性组合来表达一个数据y。我们将用于组合特征的系数记为X∈RN×p。其中,p≪N。所以,我们实际上希望找到Y^=XW,且rank(Y^)=p,使得
Y^min∣∣Y−Y^∣∣2.
通过截断 SVD,我们知道这个方程的解是Y^=UpΣpVpT。具体地,X=UpΣp,W=VpT。其实还有一种组合是X=Up,W=ΣpVpT,但一般地我们希望所得的特征向量,或者说在降维得到的特征空间中的基向量,是单位向量。这实际上是下面提到的 PCA 问题的解。
SVD 的计算代价是比较高的。Lanczos 方法是一种求解大规模矩阵的特征值的方法。
SVD 与最小二乘
我们定义最小二乘问题的形式为
bmin∣∣Ab−y∣∣22.
其中A∈Rn×d,y∈Rn均为已知量。定义上述损失为J,我们得到
∂b∂J=2AT(Ab−y)=0.
从而导出正规方程
ATAb=ATy.
ATA半正定。当ATA可逆时,我们得到解b=(ATA)−1ATy。
当ATA不可逆时,我们重新回到原本的损失函数。将A进行 SVD 分解,得到
J=∣∣UΣVTb−y∣∣22.
由于正交变换不改变向量的二范数,我们得到
J=∣∣UT(UΣVTb−y)∣∣22=∣∣ΣVTb−UTy∣∣22.
记z=VTb,c=UTy,我们得到J=∣∣Σz−c∣∣22。根据A的形状和性质,J=0可能成立也可能不成立,分为超定、欠定和唯一解:
由于Σ是一个广义对角矩阵,实际上有J=∑i=1k(σizi−ci)2,其中k为非零奇异值的个数。从这个式子不难看出,我们可以选择zi的值,使得J=0。在i≤k时,我们有zi=σici。在i>k时,zi的取值不影响损失,是自由解。这表示方程是欠定的。此时,为了取到最小范数最小二乘解,我们取zi=0。定义Σ†为Σ的伪逆(pseudo-inverse),其对角元在非零奇异值处为奇异值的倒数,在零处仍然为零。则有z=Σ†c。
将z和c的定义代回,得到
\begin{align}
V^Tb=\Sigma ^{\dagger}U^Ty. \\
b=(V\Sigma ^{\dagger}U^T)y.
\end{align}
我们得到了b的最小范数最小二乘解。记A†=VΣ†UT,称其为A的 Moore-Penrose 伪逆。
在使用正则化手段时,我们会附加损失项J=∣∣Ab−y∣∣22+λ∣∣b∣∣22。此时,正规方程变为
(ATA+λI)b=ATy.
我们在 MesaNet 的推导中与它有过一面之缘。由于(ATA+λI)是正定矩阵,它一定是可逆的,因此该方程有唯一解。将 SVD 分解代入后,我们依旧可以得到一个类似伪逆的形式,见 HW 1 中的推导。
需要注意的是“最小范数最小二乘解”和正则化约束的范数并不是一回事。最小范数最小二乘解指的是在没有任何正则化约束的目标函数下,找了范数最小的那个解。它们的目标函数不一样。
Primary Component Analysis
当X为方阵,且为可对角化矩阵时,SVD 退化到特征分解/谱分解,其形式为X=QΛQT。其中,Q的列称为特征向量,Q是正交矩阵。Λ为对角矩阵,对角元称为特征值。
从直观上理解,有一堆数据,我们试图找到p个单位向量,并以数据分布的中心为原点、以这些向量为轴张成一个空间,在这个空间中以这些单位向量为基重新表达原有数据,使其尽可能贴近原有的数据。形式上,我们有{x1,x2,…,xn},xi∈Rd,我们找到一组基{e1,e2,…,ep},使用xi~=m+∑k=1pwikek去贴合xi。m是数据中心。这等价于优化J=∑i=1n∣∣m+∑k=1pwikek−xi∣∣22。这个问题的解中,{e1,e2,…,ep}是 scatter matrix S=∑i=1n(xi−m)(xi−m)T的p个最大的特征值对应的特征向量。解起来有一点难,太菜了,不推了。
PCA 方法仍然是一种线性方法,很大程度上依赖于数据的正态分布。数据需要大致呈现聚集成单个团的分布。如果数据是多中心的,PCA 就很可能失效。
PCA 常使用 SVD 进行求解。注意到 PCA 的问题表述实际上就是我们在 “SVD 与特征分解”一节中对于特征分解的定义,PCA 中所需要求得的基实际上就是截断 SVD 中的右奇异矩阵,所需要求得的坐标实际上就是截断 SVD 中左奇异矩阵和奇异值矩阵的乘积。
Kernel PCA
Kernel PCA 方法是一种改良的 PCA 方法,相比于原始的 linear PCA 方法具有更强的非线性。KPCA 在进行 PCA 之前,先对数据应用非线性映射ϕ,然后在目标空间中进行 PCA。在目标空间中,假设数据已经通过减去均值进行中心化(即数据中心为原点),此时的散布矩阵C=∑i=1nϕ(xi)ϕ(xi)T。首先,我们有如下引理:
矩阵C=∑i=1nxixiT的特征向量v在由{x1,x2,…,xn}张成的空间中。
证明:由于Cv=λv,v=λ1Cv=λ1∑i=1nxi(xiTv)。QED
因此,对于散布矩阵C的特征向量,即 KPCA 的解,能够被表达成l=∑i=1nwiϕ(xi)。代入Cl=λl,得到
\begin{align}
\left(\sum_{i=1}^{n}\phi(x_{i})\phi(x_{i})^T\right)\left(\sum_{i=1}^{n}w_{i}\phi(x_i)\right)&=\lambda\left(\sum_{i=1}^{n}w_{i}\phi(x_i)\right) \\
\sum_{i=1}^{n} \sum_{k=1}^{n} \phi(x_{i})\phi(x_{i})^T\phi(x_{k})w_{k}&=\lambda\left(\sum_{i=1}^{n}w_{i}\phi(x_i)\right)
\end{align}
为了简化以上的条件,我们引入一个新的维度,得到
i=1∑nk=1∑nϕ(xj)Tϕ(xi)ϕ(xi)Tϕ(xk)wk=λ(i=1∑nwiϕ(xj)Tϕ(xi))
上式需要对所有的j=1,2,…,n成立。因此我们得到
K2w=λKw⇒Kw=λw.
其中Kij=ϕ(xi)Tϕ(xj)。因此,我们需要求得的w实际上是K的特征向量。
这里我们并没有指定这个向量的模长,我们只知道它是一个特征向量。下面,我们进一步计算它的模。由于我们在 PCA 的假设中要求了∣∣l∣∣2=1,所以有
\begin{align}
\left(\sum_{i=1}^{n}w_{i}\phi(x_i)\right)^T\left(\sum_{i=1}^{n}w_{i}\phi(x_i)\right)&=1 \\
\sum_{i=1}^{n}\sum_{j=1}^{n} w_{i}\phi(x_i)^T\phi(x_{j})^Tw_{j}&=1 \\
w^TKw&=1
\end{align}
因为Kw=λw,所以
wTw=∣∣w∣∣22=λ1.
这样,我们就求得了它的模长。
总结起来,KPCA 的计算流程是:
-
构造矩阵K,使得Kij=ϕ(xi)Tϕ(xj);
-
求K的特征值和单位特征向量;
-
调整特征向量的模长,即wi=λiwi;
-
KPCA 的基为li=∑k=1n(wi)kϕ(xk)。
我们知道,PCA 方法最终得到的坐标是在基上的投影,即
ϕ(x)Tli=k=1∑n(wi)kϕ(x)Tϕ(xk)=k=1∑n(wi)kk(x,xk).
一般而言,我们不需要知道 PCA 求得的具体的基,只需要知道坐标。在这个过程中,尽管我们规定了核函数ϕ,但我们从未真正形式化它,也没有具体化它的形式,而是使用k(x,y)=ϕ(x)Tϕ(y)取代了它。这就是所谓的核技巧(kernel trick):在使用非线性映射时,我们很多时候并不需要知道这个映射本身的具体形式,只需要知道目标空间中的内积函数。
#todo
Robust principle component analysis
Lec 3. Distance and Similarity
数据白化(data whitening)
经典多维标度法(multidimensional scaling, MDS)指的是一种等距变换,能够将复杂的流形拍平到笛卡尔坐标系,同时保持测地线距离意义上的距离不变性(比如把人脸的纹理拍平)。
(t-Distributed) Stochastic Neighbor Embedding, (t-)SNE, UMAP
数据白化 Data Whitening
这部分内容同步的时候被吞了,补一下。
假设我们有数据集 {x1,x2,…,xn},并构成矩阵 X∈Rn×d。我们通常希望每一个特征维度之间是独立的,因为互相相关的特征维度往往意味着冗余。比如,一张图像的邻近像素之间往往是高度相关的,也是冗余的。另一方面,我们希望特征维度之间的尺度是统一的。比如,我们将年龄和体重作为两个不同的特征维度,前者的分布范围可能是[5,50],后者的范围可能是[5,150]。即使二者进行中心化,他们的分布范围也并不相同。
我们假设 X 的每个维度分别都进行了中心化,即每个维度都减去了他的平均值。协方差矩阵为
Σ=XTX=i=1∑nxiTxi.
从元素的角度来看,Σij=∑k=1nxkixkj,实际上就是单元素协方差的定义。它刻画了特征维度 i 和 j 之间的相关性。数据白化指的是寻找一个线性变换 W,使得 y=Wx 满足我们提到的两个特征,他们被统一地描述为 Σy=I。
记分布的真实协方差为 E[xxT],则有
E[yyT]=E[WxxTWT]=WE[xxT]WT=I.
注意到 E[xxT] 是实对称矩阵且半正定,因此可对角化,且特征值非负。对其进行特征值分解,得到
E[yyT]=WUΛUTWT=I.
有多种 W 的选择可以满足上面的条件:
其一为 PCA 白化,取 W=Λ−1/2UT。直观上看,它就是将数据的主轴旋转到与坐标轴重合,然后再进行缩放,使得分布从各向异变成各向同。
其二为 ZCA 白化,取 W=UΛ1−/2UT。它在 PCA 白化的基础上附加了一个旋转,使得数据的主轴旋转到原来的位置。PCA 白化虽然完成了去相关和单位化的过程,但是会破坏原来的数据结构。比如,一张图片进行 PCA 白化之后,会失去人类可观察的视觉特征。ZCA 白化在此基础上将数据旋转回原来的位置,从而最小化和原始数据之间的距离。注意到在缩放之后,数据已经是一个各向同的分布(球形),再次旋转不会破坏白化的条件。
白化和 PCA
我们将以上的方法称为 PCA 白化,自然是因为它和 PCA 有关系。将原始数据进行 SVD 分解,记为 X=PSQT(与之前的SVD 记号有所不同,以区分白化中使用的符号):
Σ=XTX=(PSQT)T(PSQT)=Q(STS)QT=UΛUT.
因此,构造 W 中使用的 U 就是右奇异向量构成的矩阵,从前序 PCA 章节中我们知道,这也是 PCA 中构成的基,即数据的主轴。所求的 Λ 就是奇异值矩阵的平方。
实现上,通过 SVD 求得 W 的方法在数值上更为稳定,因为它不涉及求出 XTX,后者有比较大的条件数。
谱聚类 Spectral Clustering
该部分参考tutorial。课中的内容是从随机游走的角度来理解,但是略过了很多中间细节。需要了解这些细节,必须要借用一些 graph Laplacians 的工具。
假设我们有一系列散点。现在,我们根据这些散点构建一个图和图上的随机游走:
-
将每个点和它的 k-NN 连接,将它变换为图。
-
对每一个边赋权,使其代表转移的概率,距离越近,转移概率越高,比如wij=exp(∣∣zi−zj∣∣2)。同时wii=1。
这样我们就得到了一个邻接矩阵,如果进一步将每一行归一化,我们就得到了一个概率转移矩阵。我们构造一个度矩阵D,它是一个对角阵,满足
Dii=j=1∑nwij.
从图的定义上看,它表示一个顶点的度;从概率的角度看,它是每一行的归一化因子。因此,概率转移矩阵定义为
P=D−1W.
图的构造其实并不局限于这一种方式,比如我们也可以把 k-NN 这一步去掉。只要最后的邻接矩阵中,边权能够表示相似度/距离就可以。
现在,我们在这个图上进行随机游走。我们知道,t步之后到达的节点概率分布由概率转移矩阵的幂决定,即Pt。Ptij代表了从节点i出发,行走t步之后,到达j的概率。
接下来,我们尝试给出足够长时间后,我们所在位置的概率分布情况。为了推导,我们先引入图上的 Laplace 矩阵。unnormalized graph Laplacian 的定义为
L=D−W.
不难验证0是L的一个特征值,并且对应的特征向量为1。normalized graph Laplacian 具有多种定义,各自导向不同的 Laplacian,我们按照 tutorial 中的方式,给出其中两种:
\begin{align}
L_{sym}&=D^{-1/2}LD^{-1/2}=I-D^{-1/2}WD^{-1/2}. \\
L_{rw}&=D^{-1}L=I-D^{-1}W=I-P.
\end{align}
我们有如下引理:Lsym有特征值0(等价地,D−1/2WD−1/2有特征值1),特征向量为D1/21。
证明:
\begin{align}
&(D-W)\mathbb{1}&=0 \\
\Rightarrow &(I-D^{-1}W)\mathbb{1}&=0 \\
\Rightarrow& D^{1/2}(I-D^{-1}W)(D^{-1/2}D^{1/2})\mathbb{1}&=0 \\
\Rightarrow& (I-D^{-1/2}WD^{-1/2})(D^{1/2}\mathbb{1})&=0 \\
\Rightarrow& (D^{-1/2}WD^{-1/2})(D^{1/2}\mathbb{1})&=D^{1/2}\mathbb{1}.
\end{align}
QED
此时,我们再来观察Pt:
Pt=D−1/2(D−1/2WD−1/2)tD1/2.
D−1/2WD−1/2是实对称矩阵,存在特征值分解QΛQ−1。所以
Pt=D−1/2(QΛQ−1)tD1/2=D−1/2QΛtQ−1D1/2.
令t→∞。我们已经知道Λ中的一个特征值是1,同时我们还可以通过证明 normalized graph Laplacian Lrw是半正定矩阵,从而保证1是最大的特征值(半正定矩阵的特征值非负,且P=I−Lrw)。半正定性质可以直接通过定义证明,见于 tutorial。当图连通时,我们进一步保证特征值1的重数为1,因为 graph Laplacian 存在以下性质:
unnormalized graph Laplacian 的特征值0的重数与图的连通分量的数量相等,记为k。同时,特征值0的特征空间可以被k个 indicator vector 张成,其中第k个 indicator vector 为1的位置对应于该连通分量中顶点的下标。对于 normalized graph Laplacian 亦有类似结论,只是 indicator vector 的大小不同。
证明见于 tutorial。
严格来说,我们还需要证明D−1/2WD−1/2没有≤−1的特征值。严格的证明超出本文的讨论范围,我们引用 tutorial 中的一个结论:
If the graph is connected and non-bipartite, then the random walk always possesses a unique stationary distribution.
平稳分布(stationary distribution)指的是一种节点上的概率分布,如果当前所在的位置符合这个分布,并进一步地进行随机游走,下一步所在位置的概率分布与上一步相同。假如存在≤−1的特征值,P∞必然不收敛。我们使用这个结论来保证特征值的范围。
综上,在t→∞时,除了一个为1的特征值保持不变以外,其余的所有特征值对应位置都收敛到0。于是我们得到
P∞=D−1/2(λ1v1v1T)D1/2.
我们之前已经求得v1=D1/21,但这是没有 normalize 的结果,进行特征值分解的时候使用的是单位特征向量。我们定义vol(V)=∑i=1ndi,V为顶点集,则
∣∣v1∣∣=(i=1∑n(di1/2)2)1/2=√vol(V).
于是
\begin{align}
P^\infty&=\frac{1}{\text{vol}(V)}D^{-1/2}(D^{1/2}\mathbb{1}(D^{1/2}\mathbb{1})^T)D^{1/2} \\
&=\frac{1}{\text{vol}(V)}(\mathbb{1}\mathbb{1}^T)(D^{1/2})^TD^{1/2} \\
&=\frac{1}{\text{vol}(V)}(\mathbb{1}\mathbb{1}^T)D.
\end{align}
所以
Pij∞=vol(V)dj.
注意到P∞的每一行都是一样的,即不管从哪一个点出发,最后都会到达这个分布。这就是随机游走对应的平稳分布。
回到聚类问题上。除了第一个确定的特征值成分之外,一般的Pt还受到其他更小的特征值的影响。我们只保留第二大的特征值:
Pt≈D−1/2(λ1v1v1T+λv2v2T)D1/2=P∞+D−1/2(λ2v2v2T)D1/2.
在P∞上附加的项由v2v2T决定。如果v2i和v2j同符号,那么Pijt就会增大,在i和j之间跳转的概率就会增大,它们就更应该归类于同一块。因此,对于二分类谱聚类问题,它的一种解可以根据z2中的元素的符号来进行划分。
这是课上的讲法,个人觉得有点牵强。更严谨的方法将随机游走与图上分割的方法联系起来。定义两个节点集合之间的连接强度
W(A,B)=i∈A,j∈B∑wij.
定义图上分割(partition)的代价为
cut(A1,A2,…,Ak)=21i=1∑kW(Ai,Ai¯).
为了防止分割时把一个单点被分割出来,我们需要限制一个顶点集不能太小。一种改良是 Ncut:
Ncut(A1,A2,…,Ak)=21i=1∑kvol(Ai)W(Ai,Ai¯).
Ncut 可以使用图上的随机游走来表示。详见 tutorial proposition 5.
一般的谱聚类流程是:
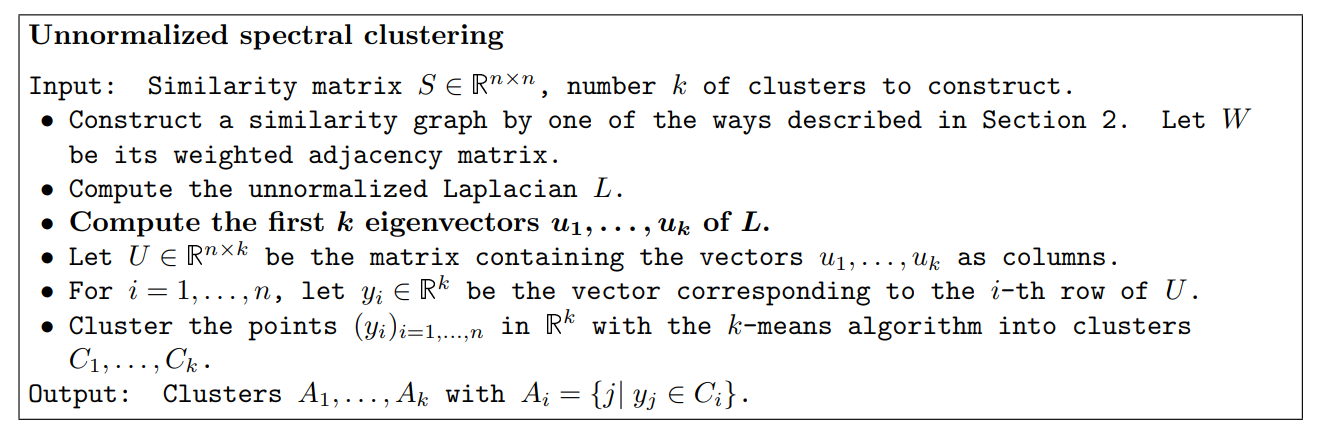
在上面的算法流程中,yi称为谱嵌入(spectral embedding)。
Gaussian Mixture Model & EM Algorithm
高斯混合模型(Gaussian Mixture Model, GMM/Mixture of Gaussian, MoG)是一类用多个高斯分布的混合去拟合一个未知概率分布的模型。记一个高斯分布的密度函数为
N(x∣μ,Σ)=(2π)d/2det(Σ)1/21exp(−21(x−μ)TΣ−1(x−μ)).
其中d为分布的维数,det为行列式记号,Σ为协方差矩阵。则一个 GMM 的形式为
P(x)=z=1∑KP(Z=z)N(x∣μz,Σz)=z=1∑KpzN(x∣μz,Σz).
K为用于拟合的高斯分布的个数。Z是一个随机变量,它的条件分布可以视为某个数据x的类标签,即P(Z=z∣x)代表数据x属于类别z的概率。我们可以通过贝叶斯公式计算这个后验概率:
P(Z=z∣x)=∑kP(Z=k)P(x∣Z=k)P(Z=z)P(x∣Z=z)=∑k=1KpkN(x∣μk,Σk)pzN(x∣μz,Σz).
假设我们分属于K个簇的一系列数据,并且我们知道这些数据的标签y(1,…,K中的某个值)。此时,我们可以求得 GMM 的参数的最大似然估计:
pz=nnz,μz=nz1yi=z∑xi,Σz=nz1yi=z∑(xi−μz)(xi−μz)T.
nz是从属于第z类的数据点的数量。但一般地来说,要使用 GMM 进行聚类时,我们是没有数据标签的。Expectation Maximization 方法利用前述的后验估计,使用当前的 GMM 对数据赋予软标签。记p^(j∣i)=P(Z=j∣xi)。这个过程称为 Expectation。Maximization 的过程是:
n^j=i=1∑np^(j∣i),pj=nnj^,μj=n^j1i=1∑np^(j∣i)xi,Σj=n^j1i=1∑np^(j∣i)xi(xi−μz)(xi−μz)T.
重复以上过程,最终可以得到一个近似于原始概率密度分布的 GMM 模型,以及每一个类对应的标签。EM 算法的每一个迭代单调地增加似然。在更抽象和一般化的形式上,对于一个含参的概率分布和一组数据,EM 算法使用如下两个步骤给出参数估计:
即
\begin{align}
J(\theta;\theta^t)&=\sum_{i=1}^{n} E_{j\sim P(j|x_i,\theta^t)}\log\left(p_{j}p(x_{i}|\mu_{j},\Sigma_{j})\right), \\
\theta^{t+1}&=\arg\max_{\theta}J(\theta;\theta^t).
\end{align}
这个写法可能有点过于抽象了,还是看上面具体的计算好一些。
原始的 EM 算法是基于最大似然的算法,同时有基于最大后验的改良算法。从形式上看,最大后验的改良形式附加了一个正则项,在计算上可以避免 EM 陷入局部最大值。具体算法略过。
K-Means
K-Means 的计算方式与 GMM 很相似,都是一种迭代式更新的方法。K-Means 计算的过程是:
-
随机选择K个点{μ1,μ2,…,μK},作为起始的簇中心;
-
将每一个点分配给距离它最近的簇中心;
-
根据当前的分配情况,更新每个簇中心的位置到簇的中心点。
K-Means 优化的目标函数是:
J=j=1∑Kxi∈Cj∑∣∣xi−μj∣∣22.
GMM 分配的是软标签,K-Means 分配的是硬标签。GMM 是 K-Means 的一般化形式;K-Means 指定的是球状簇,即在不同方向上,只要到标签中心的距离是相同的,K-Means 就赋予相同的损失,而不能考虑各向异性的分布。从形式上,当 GMM 的各个高斯子成分的协方差矩阵为对角元相同的对角阵(即σI,其中σ为标量),且对角元逐渐接近 0 时,GMM 收敛到 K-Means。前者对应于球状分布,后者指的是高斯分布收敛到一个高度尖锐的分布,即软标签到硬标签的变化。
GMM 和 K-Means 均有这样的缺陷:
-
对初始值敏感。
-
类数是超参数,决定的方式往往比较微妙。
Mean-Shift
mean-shift 的出发点是直方图。直方图是通过采样估计原分布的一种最粗略的工具,比它好一些的是近邻估计,即某个点附近的概率密度由它附近固定半径内的采样点的数量决定。如果将它变得可导,我们就得到了 Parzen estimation 方法:在每一个点的附近生成一个小的钟形线,所有的钟形线的加和即为概率密度曲线的估计。
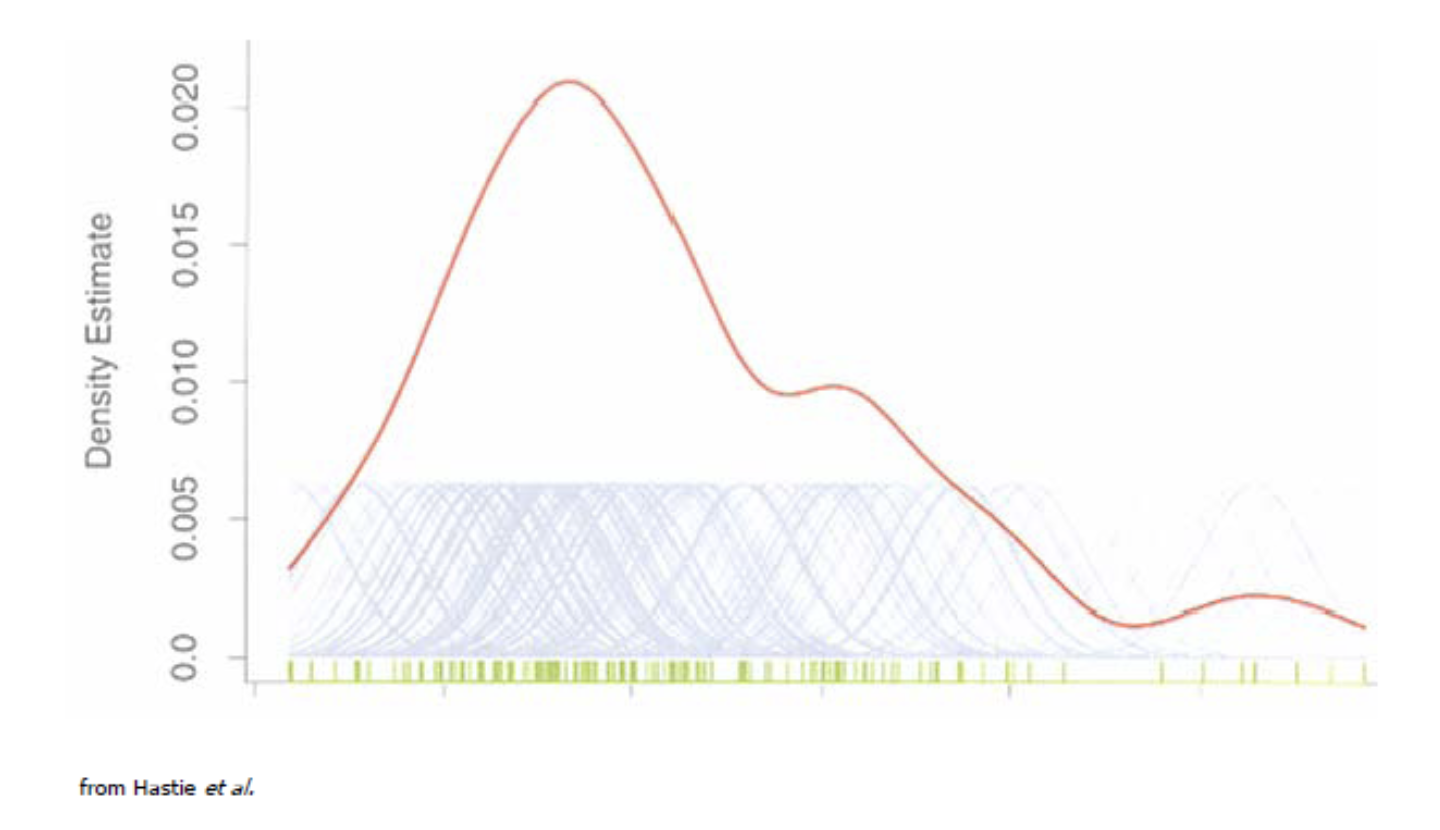
与 GMM 相比,Parzen estimation 是非参数估计方法,且具有局部性,即要分析曲线某一部分的性质(比如极大值)时,只需要知道这附近的钟形线加和就可以,因为钟形线总是快速衰减或者有界的。
在这种概率密度估计方法下,我们可以通过如下的方法进行聚类:每一个数据点在估计得到的概率密度曲线上进行梯度上升,直到到达极大值点。根据 GMM 的观点,如果概率密度曲线能够使用多个 Gaussian 的总和来表示,这里应该就是分布中心点。那么,最终稳定在同一个极大值点的数据点就被认为是同一个类别。这种方法被称为 mean-shift 方法。
应用于图像分割时,mean-shift 运行在一个五维的空间中,即 RGB 连同二维的空间坐标。
Lec 4. Probabilistic Graphical Models
该部分相关内容曾经在Beyasian Reasoning and Machine Learning中进行过介绍,可供参考。
在通过采样估计得到所有变量的联合分布之后,我们需要利用联合分布进行推断。比如,当其中一个变量固定为某一个值时(信念的更新),条件分布是什么?借由全概率公式和贝叶斯公式,我们可以进行暴力的计算,但是这往往涉及到多重的变量求和或者积分。在变量数量增多的时候,计算量很快会变得不可接受。
这就是概率图方法出现的契机。
对于一个联合概率分布,有
P(A,B,C)=P(A∣B,C)P(B∣C)P(C).
以上的分解对应于一个全连接的有向无环图。对于一定的独立条件,我们可以省略掉某些项中的条件项。这对应于删除有向无环图中的一些边。一般地,一个联合概率分布能够被分解成
P(x1,x2,…,xn)=i=1∏nP(xi∣pa(xi)).
如果没有任何条件,则pa(xi)={x1,x2,…,xi−1}。这个无环图被称为信念网络(belief network)或者贝叶斯网络。
条件独立
条件独立指的是p(x,y∣z)=p(x∣z)p(y∣z)对于任何z的取值都成立,类比于最简单的独立p(x,y)=p(x)p(y),记为x⊥⊥y∣z。它的含义是在某一个变量 z 确定的情况下,知晓 x 的状态不再能提供更多关于 y 的信息。
进一步地,我们想要表达一组网络节点X在给定另一组网络节点Z的条件下与另一组网络节点Y条件独立,这需要使用到 d-Separation 的定义和性质。此处不重复,见于之前的 Beyasian 笔记。
通过 d-Separation 的定义,我们一定程度上砍掉联合概率公式中的条件,从而简化计算。因为条件独立的等价定义是
p(x∣y,z)=p(x∣z).
某个随机变量x的马尔可夫毯(Markov Blanket)指的是这样一个集合S1,使得x⊥⊥S∖S1∣S1,其中S是所有变量构成的集合。若一个马尔可夫毯是最小的,即S1的任何真子集都不是马尔可夫毯,称其为马尔可夫边界。根据条件独立的等价定义,我们可以得到
p(x∣S)=p(x∣S1).
直观地说,马尔可夫毯中的变量集合提供了足够的信息,使得对x的计算不再依赖于其他变量。在贝叶斯网络中,一个节点的父节点集合、子节点集合和配偶节点集合的并构成了它的马尔可夫毯。
关于马尔可夫网络的内容,见原笔记。
#todo
factor graph, sum-product algorithm
Markov Chain & Hidden Markov Models
马尔可夫链指的是一个链状的贝叶斯网络,满足pa(xi)={xi−1}。需要注意,马尔可夫链和马尔可夫网络不是一个东西。马尔可夫链仍然是一种贝叶斯网络,马尔可夫网络是一种不同的概率图模型;在马尔可夫链中所说的马尔可夫性质和马尔可夫网络中的马尔可夫性质也不是一个东西。
对于xi均为离散变量的马尔可夫链,我们可以使用类似状态机的模型来表示。我们使用一个概率转移矩阵来描述从上一状态转移到下一状态时的概率分布。
接下来的讨论中,我们假设网络中的所有变量,包括隐状态变量和观测量,都是有限的离散值。我们记隐状态变量集合为{x1,x2,…,xT},其中每一个变量可能的取值范围为{q1,q2,…,qn};记观测变量的集合为{y1,y2,…,yT},其中每一个变量的取值范围为{o1,o2,…,on}。
有时,状态量qi本身不能够直接被观测或者描述,我们只能通过观察量与状态之间建立联系。比如,在进行语音识别时,我们关心的是对应的文字序列及其概率分布,而我们能够观测到的只有声学信号。为了建模这种过程,我们在马尔可夫链{q1,q2,…,qn}的基础上,再加入一个概率矩阵,用于描述状态qi和观察oi之间的关系。这种模型被称为隐马尔可夫模型(Hidden Markov Models, HMM)。HMM 实际上还是一个具有特定形式的贝叶斯网络,概率图形式如下:
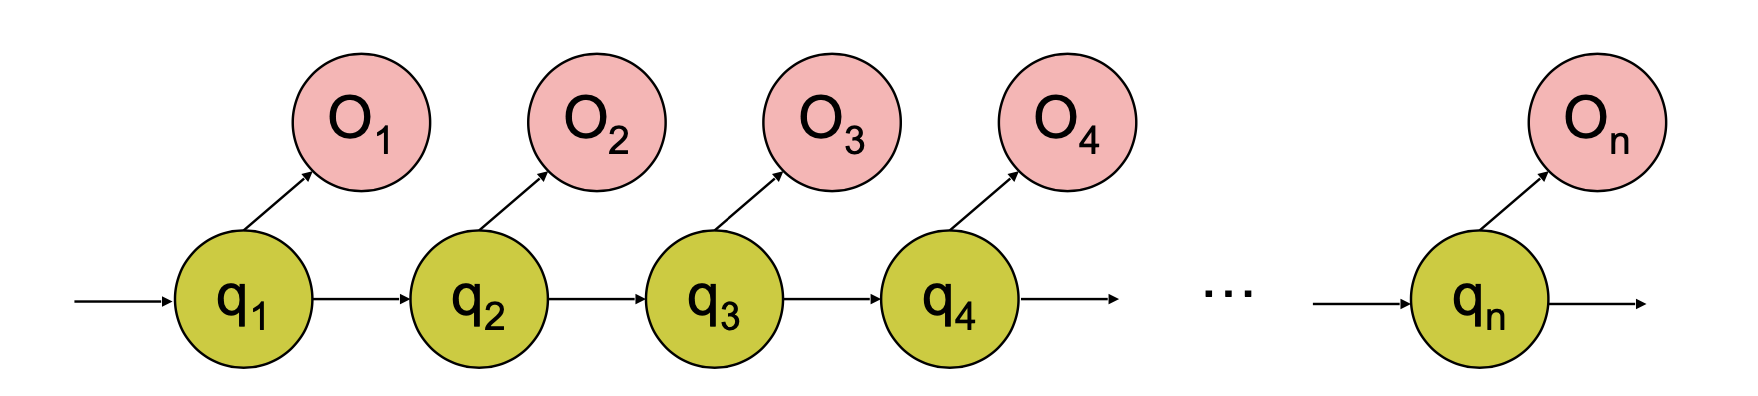
接下来,我们记aqiqj为每一步中隐状态从qi转移到qj的概率,即p(xi+1=qj∣xi=qi);记bqioj为当隐状态为qi时,观察量为oj的概率,即p(o=oj∣x=qi);记πqi为初始状态为qi的概率。HMM 有三类问题:
-
评估:我们知道 HMM 系统的概率模型,即知道两个概率转移矩阵的具体值,也知道已经发生的一系列观察{o1,o2,…,on},求解该观察发生的可能性。
-
解码:我们知道 HMM 系统的概率模型,也知道已经发生的一系列观察{o1,o2,…,on},求解此时最有可能的隐状态序列{q1,q2,…,qn}。
-
学习:我们只知道系统符合 HMM 的模型,不知道具体的概率转移值。已知发生的一系列观察(或者连同此时发生的隐状态),求解系统的参数。
Lec 5. Linear Programming
这个部分会写得比较简单一点,因为本人实际上对线性规划兴趣不是很大()
线性规划问题的标准形式定义为
\begin{align}
\min c^Tx, s.t. Ax\leq b,x\geq 0.
\end{align}
其中,cTx是一个线性的目标函数,c称为价值向量(cost vector)。Ax≤b是一系列的线性不等式约束,A称为约束矩阵(constraint matrix)。一般来说,我们要求变量非负。
满足约束条件的任意x称为可行解(feasible point),所有可行解构成的集合称为可行域(feasible region),记为D。对于线性规划问题,存在以下情况:
通过引入松弛变量,我们可以将不等式约束转换为等式约束:
i=1∑najixi≤bj⇒i=1∑najixi+xi+1=bj,xi+1≥0.
线性规划中有很多这样的技巧。这样,我们将标准形式转换为
\begin{align}
\min c^Tx, s.t. Ax= b,x\geq 0.
\end{align}
对于这样一个规划问题的可行域S={x∣Ax=b,x≥0},容易验证其具有仿射性质,即∀x,y∈S,λ∈R,λx+(1−λ)y∈S。等价且直观地说,这个可行域是一个仿射集合,它实际上是一个线性子空间加上一个偏移量之后构成的空间。
类似地,当∀x,y∈C,λ∈(0,1),λx+(1−λ)y∈C,则C称为凸集。与仿射集的定义对比,凸集约束了组合系数的取值范围。容易验证,线性规划问题的可行域也是凸集。u=λx+(1−λ)y称为一个凸组合,或者称为线段(x,y)的内点。
进一步地,我们定义凸集的边界。我们称C′⊂C是C的一个界面,如果
∀u∈C′:x,y∈C,u=λx+(1−λ)y⇒x,y∈C′.
直观地说,一个二维凸多边形的一条边是它的界面,顶点也是它的界面。所有的顶点,或者说,所有0维的界面,称为极点。更直观地说,极点不是C中任何线段的内点。
基本可行解
对于线性规划问题的主要约束条件Ax=b,我们总是考虑秩亏的情形,这样才会产生一个以上的可行解。这意味着约束条件总是少于变量,即A∈Rm×n,m<n;同时我们约定约束条件之间相互独立,即rank(A)=m。在这种情况下,A有m个线性无关的列向量。我们通过基本变换交换A的列,使方程变换成
(BN)(xBxN)=BxB+NxN=b.
并使得B可逆。此时,我们得到
xB=B−1b−B−1NxN.
这意味着xN是自由解;给定任意的xN,我们都能够通过上式得到相应的xB。我们取一个平凡的情况xN=0,此时的解称为基本解。注意到,此时得到的完整解(xB,xN)并不一定满足x≥0这个条件,因此基本解未必是可行解。一个线性规划问题有可以有不止一个基本解,因为通过基本变换得到的满足条件的B不一定只有一个;满足x≥0的基本解称为基本可行解。B称为基,其中的列向量称为基向量。xB中对应的变量称为基变量,xN中的变量称为非基变量。对于基本可行解,我们有如下定理:
以下三者等价:
-
可行解x是基本可行解;
-
可行解x的正分量在约束矩阵A中对应的列的列向量之间线性无关;
-
x是可行域的极点。
证明:1和2之间显然,即为基本可行解的定义。
1&2⇒3:我们调换x中的变量顺序,使得正分量对应的变量为{x1,x2,…,xk}。假设∃x1,x2∈D,使得x为x1和x2的凸组合。因为x1,x2∈D,所以我们有Ax1=Ax2=b,即A(x1−x2)=0。我们使用矩阵乘积的外积公式展开,得到
i=1∑n(xi1−xi2)ai=0.
其中ai为A的列向量。我们分两段讨论这个求和:
-
k<i≤n时,我们有xi=0。由于x是x1和x2的凸组合,所以只能有xi1=xi2=0。
-
i≤k时,因为{a1,a2,…,ak}之间线性无关,要使它们的线性组合为0,所以只能有xi1=xi2。
综上,我们只能得到x1=x2;这也是极点的等价定义。
3⇒1&2:反证法。我们仍然将变量顺序重排,将所有的k个正分量对应的变量放在前面;假设存在一组非全零的系数{y1,y2,…,yk},使得
i=1∑kyiai=0.
我们构造向量(y1,y2,…,yk,0,…,0),使得
i=1∑nyiai=0.
由于Ax=b,仍然使用外积公式展开,我们得到
∀λ∈R,i=1∑n(xi+λyi)ai=b.
此时,我们可以随便取两个点,比如{x+λy,x−λy}(λ≠0)。根据上式,我们知道这两个点都在可行域构成的凸集内;但这两个点不重合。这与极点的定义是相悖的(不是凸集中任何线段的内点)。QED
以上的定理确定了基本可行解的几何意义,即每一个基本可行解对应于凸集的一个顶点。为了表达凸集无界的情况,我们定义凸集的方向。如果一个非零向量d,∀x∈S,{x+λd∣λ≥0}⊂S,我们称d为S的一个方向。直观上,一个凸集会沿着它的方向无限地延伸。如果一个方向不能够表达为两个方向之间的正线性组合,则称它为S的极方向(extreme direction)。直观上,极方向是所有方向中最边缘的一个;它代表了贴着S的边缘不断延伸的一个方向。
在此基础上,我们引入线性规划基本定理/表示定理:
给定一个可行域的所有极点{x1,x2,…,xk},以及所有的极方向{d1,d2,…,dl}。一个点x在可行域内,当且仅当它能够表示成
x=i=1∑kλixi+i=1∑lμidi.
其中λi≥0,μi≥0,∑i=1kλi=1,即所有极点的凸组合附加所有极方向的正线性组合。
由表示定理,我们有以下推论:对于标准形式的线性规划问题(等式约束),
-
目标函数存在有限个最优值的充要条件是对于可行域的所有极方向dj,均有⟨c,dj⟩≥0;
-
如果目标函数存在有限个最优值,则必定在可行域的某个极点上取到。
证明(粗糙的):我们将基本表示定理代入目标函数,得到
\begin{align}
\min c^Tx=\min \left( \sum_{i=1}^k(c^Tx^i)\lambda_{i}+\sum_{i=1}^{l} (c^Td^i) \mu_{i} \right).
\end{align}
我们知道,μi是无上界的,假如存在一个dj使得cTdj<0,目标函数就没有下界。因此,要有有限个最优值,就必须要求cTdj≥0。
在cTdj≥0的条件下,在最优值处必有μi=0。对于前一项,对于这样一个线性组合,只有把权重全部分配给价值最小的点时才能取到最小值。因此,最优值必定在极点上取到。QED
根据上文中的推导,这意味着最优值必定在基本可行解中取到。至此我们可以看出,求解线性规划问题的基本方式是比较所有极点/基本可行解上的目标函数值,找到其中的最优者即可。但是,在变量数目较多时,基本可行解的数量往往较多,计算上是不可行的。单纯形法就是在此基础上诞生的方法。
单纯形法 Simplex Method
单纯形法的核心是在已经得到一个基本可行解的基础上,判断一个解是否是最优解;如果不是,转移到下一个基本可行解,并进行迭代。所以,我们关心的第一个问题是:如何判定一个基本可行解是否已经是最优解。
检验向量
我们对价值向量进行与基本解相似的分块,并代入基本解的形式,得到
mincTx=mincBT(B−1b−B−1NxN)+cNTxN=cBTB−1b+min(cNT−cBTB−1N)xN.
我们知道自由解的部分xN≥0,而在基本可行解处有xN=0。直观上,在极点处,任何向可行域内的移动都会导致xN成为非零向量。如果向量(cNT−cBTB−1N)的所有分量为正值,那么不管向何处移动均会增加代价,因此这个极点就是局部最优点。在线性规划中,这就意味着这个点是全局最优点。该向量被称为检验向量。在不同的推导中,取决于优化目标和这个向量是否取反,形式可能有所不同。不过就结果而言是一致的。一般而言,我们将判别标准记为检验向量的分量均为负值,此时将检验向量记为(cBTB−1N−cNT)即可。
当检验分量中存在一个为0的分量时,意味着可行域中沿着某个方向移动不会改变此时的代价大小。此时,线性规划问题有无穷多解。
当检验分量中存在一个正的分量时,此时当前的极点显然不是最优解,我们需要移动到下一个极点。具体的做法是将正分量对应的变量和另一个非自由变量调换,具体就不展开了。因为这部分内容实在不是很有趣()
单纯形法的最差复杂度是指数级的。后来发展出了投影尺度算法,即从可行域内逐渐走向最优的极点的方法。
#todo
对偶问题,支持向量机
Lec 7-8. Nonlinear Optimization
在数学上,对一个迭代求解收敛法的收敛速度定义是
\\lim_{ k \to \infty } \frac{||x_{k+1}-x^*||}{||x_{k}-x^*||^\alpha}=q.
其中α和q为常数。当上式成立时,称为算法有α阶的收敛速度。
以牛顿法为例。在一个一次的非线性函数f(x)上,牛顿法在当前的位置创造出一个二次拟合曲线,要求函数值、一阶导数、二阶导数在此处与原函数相同。然后,使用该二次曲线的顶点横坐标作为下一步的位置。假设二次函数为g(x)=ax2+bx+c,则顶点为x=−2ab。由g′′(xi)=2a=f′′(xi),g′(xi)=2axi+b=f′(xi),g(xi)=axi2+bxi+c=f(xi),得到
xi+1=−2ab=−f′′(xi)f′(xi)−f′′(xi)xi=xi−f′′(xi)f′(xi).
牛顿法的收敛速度是二阶,但同时意味着需要求解二阶导数。在高维情形下,意味着需要求解 Hessian 矩阵。需要注意的是,这里所说的牛顿法指的是牛顿法求极值。另一种常见的形式是牛顿法求函数根,即在某一点 xi 处求出函数的切线,并求切线与 x 轴的交点,作为下一个 xi+1。它的形式是
xi+1=xi−f′(xi)f(xi).
上面两种形式其实是统一的,因为求函数的极值基本等价于求导数的根(局部地)。容易验证,如果牛顿法被直接应用于线性方程 f(x)=Ax−b 的求根,它将在一步之内收敛。
牛顿法也可以视为一点二次方法,即只使用一点的信息进行估计。也可以扩展到二点二次方法,即使用两点处的函数值和其中一点的导数:
\begin{align}
ax_{i-1}^2+bx_{i-1}+c&=f(x_{i-1}), \\
ax_{i}^2+bx_{i}+c&=f(x_{i}), \\
2ax_{i}+b&=f'(x_{i}).
\end{align}
从而求解出a,b,c。二点二次方法只需要计算一阶导数,但是收敛速度略慢,速度为1.618阶。如果只使用三点的函数值进行计算,方法进一步退化为零阶方法,同时收敛速度进一步下降。二点三次方法指的就是 Hermite 插值。
梯度下降法是线性收敛的算法。
在数学的定义下,梯度下降法指的是在迭代搜索时使用梯度的反方向作为搜索方向的迭代法。在数学语境下,步长的确定是一个复杂的过程,并不像深度学习中一样作为超参数任意指定(实际上深度学习中也并不是,adam 优化器的核心就在于自适应步长)。在最理想的情况下,步长λi应当满足:
λi=argλminf(xi+λdi).
即步长的确定构成另一个一维的优化问题。di指的是搜索方向,在梯度下降的语境下指的就是梯度的逆方向。在这种条件下,我们可以得到以下推论:
⟨∂x∂f(xi+λidi),di⟩=0.
其中di=−∂x∂f(xi).
证明:令ϕ(λ)=f(xi+λdi),则
\begin{align}
\frac{\partial \phi(\lambda)}{\partial\lambda}=f(x_{i}+\lambda d_{i})^Td_{i}.
\end{align}
因为λi=argminλf(xi+λdi),所以
\begin{align}
\frac{\partial \phi}{\partial\lambda}(\lambda_{i})=f(x_{i}+\lambda_{i} d_{i})^Td_{i}=0.
\end{align}
QED
注意到di+1=−∂x∂f(xi+λidi),所以有⟨di,di+1⟩=0,即理想梯度下降的每一步更新方向都正交,更新轨迹必定呈现为锯齿状。
高维牛顿法具有比梯度下降法更好的收敛性。高维牛顿法依赖于泰勒展开,即
f(xi+s)≈q(xi+s)=f(xi)+∇f(xi)Ts+sT∇2f(xi)s.
本质上和上面说到的一点二次方法是一样的。因此我们得到
xi+1=xi−[∇2f(xi)]−1∇f(xi):=xi−Gi−1gi.
其中Gk为 Hessian 矩阵。牛顿法可以看成使用 Hessian 矩阵结合梯度方向修正更新方向的梯度下降法。高维牛顿法的主要困难在于 Hessian 矩阵不一定正定,因此不一定可逆。因此,牛顿法的收敛性指的是局部收敛性,即在局部范围内二次收敛;但难以保证全局的收敛性。对牛顿法的改良大多集中在 Hessian 矩阵上。
信赖域方法/Levenberg-Marquardt 方法
信赖域指的是一个更新步长,并限制当前的更新量的赋值不能超过这个步长。LM 方法是信赖域方法中的一类。LM 方法仍然使用单点二次展开作为当前函数的局部估计,但是不再使用替代二次函数的顶点作为下一步的位置,而是使用有限范围内的最小点:
sminf(xi)+∇f(xi)Ts+sT∇2f(xi)s,s.t.∣∣s∣∣≤hi.
即相比于原始的牛顿法,多了最后的一项约束。
进行以上的一次更新,相当于求解这个受约束优化问题。我们写出他的 Lagrange 乘子:
L(s,μ)=f(xi)+∇f(xi)Ts+sT∇2f(xi)s+μ(sTs−hi2).
这个乘子达到最优值的必要条件是 KKT 条件。我们知道,它至少要满足
∂s∂L=∇f(xi)+∇2f(xi)s+μs=0.
即
\begin{align}
g_{i}+(G_{i}+\mu I)s=0. \\
(G_{i}+\mu I)s=-g_{i}.
\end{align}
可以看到,如果乘子μ=0,LM 方法就会退化到牛顿法的形式。另一方面,如果乘子μ比较大,达到足以忽略Gi带来的影响,优化问题就退化到接近梯度下降的形式。
共轭方向方法/共轭梯度法 Conjugate Gradient
共轭方法是一类介于线性收敛的梯度方法和二次收敛的牛顿方法之间的方法,可以避免求解 Hessian 矩阵或者要求目标二阶可导,但是收敛速度高于一阶。
我们首先定义向量的共轭。给定一个对称正定阵G,若两个向量d1,d2满足d1TGd2=0,称它们是G-共轭的。共轭实际上就是正交关系的一种推广,当G=I时退化到正交。如果对G进行特征值分解,我们得到
d1TGd2=(d1TQT)(Qd2)=0.
实际上指的就是这两个向量在经过一个变换之后互相正交。与正交关系类似地,如果一组向量之间两两关于G共轭,称这组向量是关于G共轭的。同样,当一组向量关于G共轭时,它们之间彼此线性无关。
证明:反证法,假设这组向量线性相关,即存在一组非全零的参数{λ1,λ2,…,λn},使得
i=1∑nλidi=0.
左乘djTG,利用共轭条件,得到
i=1∑nλidjTGdi=λjdjTGdj=0.
由于G对称正定,djTGdj>0,所以只能有λj=0。以此类推,可以得到λi=0,i=1,2,…,n。矛盾。
QED
二次函数上的共轭梯度法
我们考虑一个正定二次型:
f(x)=21(x−x0)TA(x−x0).
考虑它的等值线 21(x−x0)TA(x−x0)=C,可以发现其实是一个平移之后的椭圆。直观起见,我们给出一个具体的例子:取 x=[x,y],x0=(0,0),A=diag(2,1)。这样,我们得到 z=x2+21y2。它的函数景观如下所示。
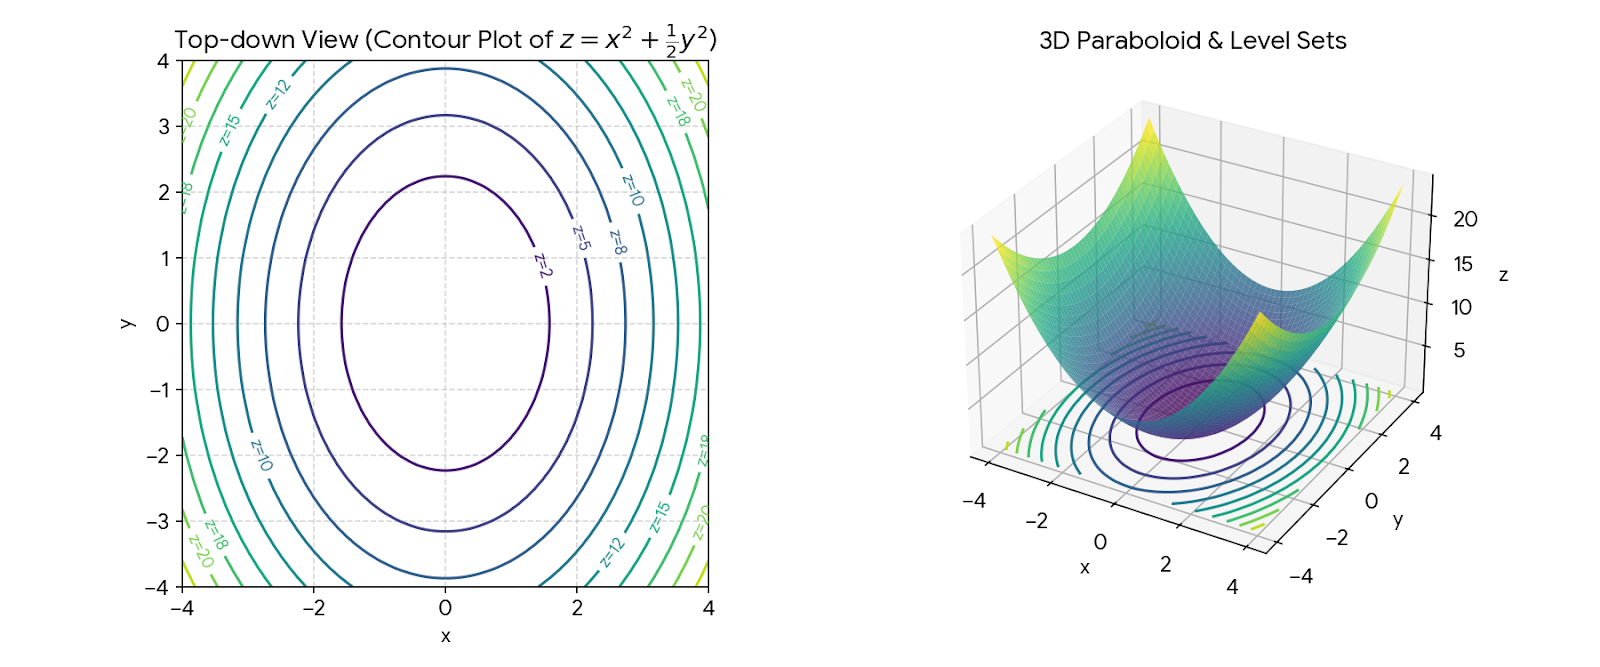
假设我们从某一个点 x0 出发,沿着方向 d1 进行搜索。我们尝试找到最优步长。在上图左侧的等值图上,越靠近中心地区,函数值越小,因此最优步长必定是离中心最近的时候取到。此时到达 x1,一定有 d1 与当前所到达的等值环相切。在 x1 处,梯度即为等值线的法向量(将等值线参数化可证)。此处的梯度是
∇f(x)=A(x−x0),∇f(x1)=A(x1−x0).
因此,
d1TA(x1−x0)=0.
如果我们将下一次的搜索方向置为 d2=(x1−x0),这个方向将经过整个函数的中心,即函数的最低点。换言之,在二维情形下,第二次搜索必然取到最优值。注意到 d1TAd2=0,因此 d1 和 d2 关于 A 共轭。
需要注意的是,这并意味着只要找到一个与 d1 共轭的 d2,d2 就一定穿过函数中心。我们举的例子是二维自变量的,所以找到的 d2 必然穿过函数中心。如果考虑一个更加高维的情况,比如 u=f(x,y,z)(可以想象成一个三维空间中的标量场),就像与 d1 正交的向量沿着某个方向旋转不会改变内积一样,我们也能找到“一圈”的 d2,使得它和 d1 共轭。在常见的共轭梯度法中,我们之所以能够确定性地找到一个唯一的 di+1,是因为预先假设了 di+1 的形式。
更广泛地,对于一个 d 维空间内的正定二次型极小值问题,共轭梯度迭代必在 d 步以内收敛到最优解。形式化地,
#theorem
对于一个正定二次型 y=21xTAx−bTx+c,A∈Rn×n,假设 {d1,d2,…,dk} 是一组关于 A 共轭的向量,从初始解 x1 出发,依次沿着 {d1,d2,…,dk} 进行最优步长搜索,得到 {x2,x3,…,xk+1},其中 xk+1 必为 x1+span(d1,d2,…,dk) 上的极小点。当 k=n 时,一定取到全局最小值。
证明:首先,证明 xk+1 是在 x1+span(d1,d2,…,dk) 上的极小点,等价于证明 xk+1 处的梯度 gk+1 正交于该子空间中的所有基向量。由于 {d1,d2,…,dk} 就是一组基向量,这等价于证明
gk+1⊥dj,∀j=1,2,…,k.
要理解这一点,如果 gk+1 在任何一个基向量的方向上还有分量,就说明在顺着该分量方向继续前进之后,还能找到值更小的点。所以 gk+1 必须指向该子空间之外。这种理解和下篇中的 QR 分解的理解是很相似的。
归纳法证明。当 k=1 时,上面的正交条件由最优搜索直接保证。当 k>1 时,我们先来求 gk+1。我们知道
xk+1=x1+i=1∑kαidi.
又有 ∇f(x)=Ax−b,我们得到
gk+1=Axk+1−b=Ax1−b+i=1∑kαiAdi=g1+i=1∑kαiAdi.
然后我们来求 djTgk+1:
djTgk+1=djTg1+i=1∑kαidjTAdi=djTg1+αjdjTAdj.
将上两式回退到 k=j 处,得到
\begin{align}
g_{j+1}&=g_{1}+\sum_{i=1}^{j} \alpha_{i}Ad_{i}, \\
d_{j}^Tg_{j+1}&=d_{j}^Tg_{1}+\sum_{i=1}^{j} \alpha_{i}d_{j}^TAd_{i}=d_{j}^Tg_{1}+\alpha_{j}d_{j}^TAd_{j}=0.
\end{align}
第二式由归纳法条件成立。因此,djTgk+1=0。QED
共轭梯度法本质上对二次型的求解进行了换基,并使得在新的基下 n 维问题的求解被分解成 n 个独立的一维问题,从而实现高速收敛。在 f(x)=21(x−x0)TA(x−x0) 这个形式中,重新令
x−x0=i=1∑ncidi.
得到
\begin{align}
f(x)&=\frac{1}{2}\left( \sum_{i=1}^{n} c_{i}d_{i} \right)^TA\left( \sum_{j=1}^{n} c_{j}d_{j} \right) \\
&=\frac{1}{2}\sum_{i=1}^{n} \sum_{j=1}^{n} c_{i}c_{j}(d_{i}^TAd_{j}) \\
&=\frac{1}{2}\sum_{i=1}^{n} (d_{i}^TAd_{i})c_{i}^2.
\end{align}
与最优步长的梯度下降法相比,梯度下降法两步之间的搜索方向必然正交,共轭梯度法两步之间的搜索方向必然共轭。
共轭梯度法的实现
共轭梯度法的大体框架和梯度下降法实际上是一样的;它们都是选定某一个方向,然后在这个方向上进行最优步长搜索,从而得到下一个迭代点。梯度下降每次的方向就是梯度方向,共轭梯度法每次的方向是共轭方向;因此主要问题即为如何求解共轭方向。由于 CG 最常见的形式是用于求线性方程组 Ax=b,我们将考虑下面的正定二次型:
y=ϕ(x)=21xTAx−bTx.
初始解为 x1=0,初始搜索方向为负梯度 d1=b−Ax1=r1(step 0)。最优步长求解为
αkminϕ(xk+αkdk).
这是一个简单的标量二次函数,它的解是(step 1)
αk=dkTAdkrkTdk.
然后进行更新当前点和残差(step 2-3):
\begin{align}
x_{k+1}&=x_{k}+\alpha_{k}d_{k}, \\
r_{k+1}&=r_{k}-\alpha_{k}Ad_{k}.
\end{align}
我们假设下一步的搜索方向 dk+1 具有如下形式(step 4):
dk+1=−gk+1+βkdk=rk+1+βkdk.
由于 dkTAdk+1=0,得到
rk+1TAdk+βk(dkTAdk)=0.
即(step 3)
βk=−dkTAdkrk+1TAdk.
重复 step 1-4,即 CG 的完整迭代过程。不过,在常见的形式中,αk 和 βk 的求解还会进一步简化。对于 αk,利用 dk=rk+βk−1dk−1,以及 rkTdk−1=0(梯度与等值线相切),得到
αk=dkTAdkrkTrk.
对于 βk,利用 rk+1=rk−αkAdk,得到
\begin{align}
Ad_{k}&=-\frac{1}{\alpha_{k}}(r_{k+1}-r_{k}), \\
\beta_{k}&=\frac{r_{k+1}^T}{d_{k}^TAd_{k}}\cdot \frac{1}{\alpha_{k}} \cdot(r_{k+1}-r_{k})=\frac{r_{k+1}^Tr_{k+1}-r_{k+1}^Tr_{k}}{\alpha_{k}d_{k}^TAd_{k}}.
\end{align}
由于 rk+1⊥rk(懒得证了,就是上面的子空间极小化条件),再加上 αk 的形式,得到
βk=rkTrkrk+1Trk+1.
拟牛顿法 Quasi-Newton



Comments NOTHING