本篇包括一些自动微分的进阶论述,以及 torch 中 vjp 的使用和相关注意事项。不过,目前测试下来,torch 中的 vjp 相关功能可能坑挺多,或许不适合作为一个常用的操作使用,更适合作为一个极限的 trick。所以,vjp 可能更适合作为一种严格推导梯度的工具,而不是作为一个常见的工程实践。
About Jacobian
或许很多人第一次接触自动微分的途径都是 computational graph,即基本的链式法则。比如,对于以下的操作:
y=σ(Wx+b).
我们通过将其分解为
\begin{align}
z&=Wx+b \\
y&=\sigma(z).
\end{align}
于是我们能够非常容易地写出
∂x∂L=∂y∂L∂z∂y∂x∂z.
这个式子其实完全是不严谨的,我们只是使用了类似标量求导的规则“猜”了这么一个东西。首先,我们没有定义其中每一项的具体含义。事实上,这里面的每一个量都是雅各比矩阵。其次,也是更重要的一点,我们没有定义这些量之间互相作用的方式。上面这个式子是把算子省略掉了,而不是默认它们之间是乘法关系。矩阵之间讲“乘法”,也是一个不严谨的表达。它指的是逐点乘,还是矩阵乘?
在简单的工程实践中,我们一般不怎么关注这些问题,而是直接进行一个标量数学和矩阵分析的乱炖。比如,我们可以直接猜测
∂x∂z=W.
因为标量里面就是这么作用的。至于形状,我们甚至不关心∂x∂z的定义,自然暂时也不关心它的形状。等到需要把它们拼凑起来的时候,核对一下彼此的形状,并找到一种运算,使得这些东西串起来是合法的,并且最终的形状就是∂x∂L的形状,那就可以了。尽管以上过程从数学的角度来看非常猎奇,但它一般来说是对的。因为矩阵之间交互的方式就那么几种,而且最终产出的结果往往也确实和标量代数中的结果类似。
为了让事情变得严谨一些,我们需要把上面提到的一系列没定义的东西定义好。首先,对于y=f(x),x∈Rm,y∈Rn,我们定义雅各比矩阵(Jacobian matrix)
J=∂x∂y∈Rn×m,Jij=∂xj∂yi.
即分量对分量的偏导数构成的矩阵。当输出为标量,比如损失函数L时,符号∂x∂L也是一个雅各比矩阵,但是在形状上退化到一个向量。需要注意的是,雅各比矩阵并不总是一个二维的矩阵。比如,在求权重的梯度时,我们在形式上会看到如下计算:
∂W∂L=∂y∂L∂W∂y.
最后一个量实际上应当是一个三维的张量,我们可以通过将W摊平来延续之前的定义。但在工程上,我们从来没有见过这样一个高维的 tensor。这是因为我们从未将这个 tensor 实例化过;我们通过计算 vector-jacobian product 来避免了这个开销。
Vector-Jacobian Product
vector-jacobian product (vjp) 和第二个问题高度相关:雅各比矩阵之间是如何作用的?
事实上,我们知道这个作用并没有统一的表达。我们都知道 Linear 层的反向传播中,作用在梯度上的仍然是一个矩阵乘;任意的逐点非线性函数,作用在梯度上的形式也是逐点作用。不同的操作导致的反向传播作用方式并不一致,抽象地说,雅各比矩阵之间通过某种形式的张量收缩(tensor contraction)发生作用。张量收缩指的是两个矩阵之间发生作用,消除掉其中的某些维度,并产出一个结果矩阵的过程,或许叫它 Einstein 求和更亲切一些。
由于求和的形式随着操作的类型而变化,一个反向传播系统要真正完成反向传播的过程,它所要知道的不仅是某个算子(数学上的映射)对应的 jacobian 矩阵,同时也要知道这个 jacobian 矩阵如何作用于回传的梯度上。更具体地,对于如下的操作
∂W∂L=∂y∂L∂W∂y
框架要知道的不仅仅是那个 jacobian,即∂W∂y,还需要知道如何把它作用在∂y∂L上。由于回传的梯度∂y∂L总是一个向量(因为损失总是一个标量),这个作用总是一个向量与 jacobian 矩阵之间的作用,称之为 vector-jacobian product。
更进一步地,我们其实并不真的需要把这个 jacobian 矩阵写出来。换个角度来看,vjp 实际上是一个函数vjp(x),它满足
vjp(∂y∂L)=∂W∂L.
这样的看法有一个好处:这个函数的输入输出都是向量或者二维的矩阵,那个庞大的三维张量不见了。当然,这个函数最数学的实现方式仍然是通过乘上那个三维张量来实现,但是通常地来说,vjp 的计算过程不需要完全实例化 jacobian 矩阵,对于很多算子来说都是这样。我们会在下面的常见 VJP 中看到这一点。这能够节省大量的显存开销。
常见算子的 VJP
以上是从工程的视角来看待问题。从数学的视角上,现在我们知道,为了严格定义整个反向传播链的计算过程,我们需要使用 vjp 来计算他。换句话说,vjp 才是定义反向传播过程的严格方式。
下面是一些常见的 VJP 公式。它们在一些数学推导中很有用。
(1) Linear。向量形式:
y=Wx,W∈Rm×n,x∈Rn×1,y∈Rm×1.
Jacobian:
∂x∂L=WT∂y∂L,∂W∂L=∂y∂LxT.
矩阵形式:
Y=XWT,W∈Rm×n,X∈RB×n,Y∈RB×m.
Jacobian:
∂X∂L=∂Y∂LW,∂W∂L=(∂Y∂L)TX.
(2) Normalization:
y=∣∣x∣∣2x,x∈Rd,y∈Rd.
Jacobian:
∂x∂L=∣∣x∣∣21(∂y∂L−y(yT∂y∂L)).
(3) elementwise nonlinear:
y=σ(x),x∈Rd,y∈Rd.
Jacobian:
∂x∂L=∂y∂L⊙σ′(x).
(4) self correlation:
Y=XXT.
这个式子看上去不是那么常见,但其实还是经常出现的。比如KKT。这个 jacobian 的计算也是最难的一个,拆成分量来推导是比较繁琐的,如果去问 LLM 的话多半会拿到一个利用矩阵微分理论算出来的更简洁的解,不过笔者对此并不精通,大多数的深度学习微分理论也不会用到这么深的理论。
为了给出它的解,我们展示一点它的中间过程。在拆成分量推导之后,我们会得到一个形式:
∂xi∂L=k=1∑m(∂Yik∂L+∂Yki∂L)xk.
其中xi是X的行向量,m是X的行数。考虑最通用的情况,我们认为∂Y∂L不是一个对称矩阵,那这个解的矩阵形式就是
∂X∂L=(∂Y∂L+(∂Y∂L)T)X.
但一般而言,由于Yik=⟨xi,xk⟩,Yik与Yki一般来说是对等地参与到 loss 的计算中,毕竟很难想象同样是xi和xk的相似度,只是因为在矩阵的上半部分和下半部分就对 loss 产生不同的贡献。这种情况下,反馈回来的梯度也应该是对等的,所以∂Y∂L是一个对称矩阵。所以
∂X∂L=2∂Y∂LX.
(5) 二次型:
y=xTAx.
Jacobian:
∂x∂L=2Ax⋅∂y∂L.
矩阵形式:
Y=XAXT.
先写这么多,想到了再补充。事实上深度学习常用的算子并没有多少,剩余的很多操作涉及到指标重排,对应的梯度也是上游梯度的重新排列;亦或者体现为上面这些操作的组合。
VJP in Pytorch
需要再次提醒,pytorch 的 vjp 功能并没有特别好使,很难说使用 vjp 再进行反向传播时会不会出现一些坑,计算开销也很难控制。尽管如此,客观上确实存在这样一些 utils,能够允许我们将任意 torch 函数的反向过程抽象出来使用。
在上文中,我们对 vjp 进行了这样的形式化:
vjp(∂y∂L)=∂W∂L.
更一般地,对于任意一个可微的函数y=f(x),它对应的 vjp 接受它的上游梯度∂y∂L,输出它的下游梯度∂x∂L。vjp 函数的接口一般将上游梯度抽象成一个一般化的向量v,允许用于进行传入。我们需要保证传入的值是某一个上游的梯度,才能保证数学上的正确性。当然也有一些特殊的用法;如果f的输出就是一个标量的 loss,并且将传入的v指定为torch.tensor(1.0),那么 vjp 进行的过程就相当于 backward。
截至目前,torch 一共有两个计算 vjp 的函数,我们先看这个新一些的。torch.func.vjp的接口如下:
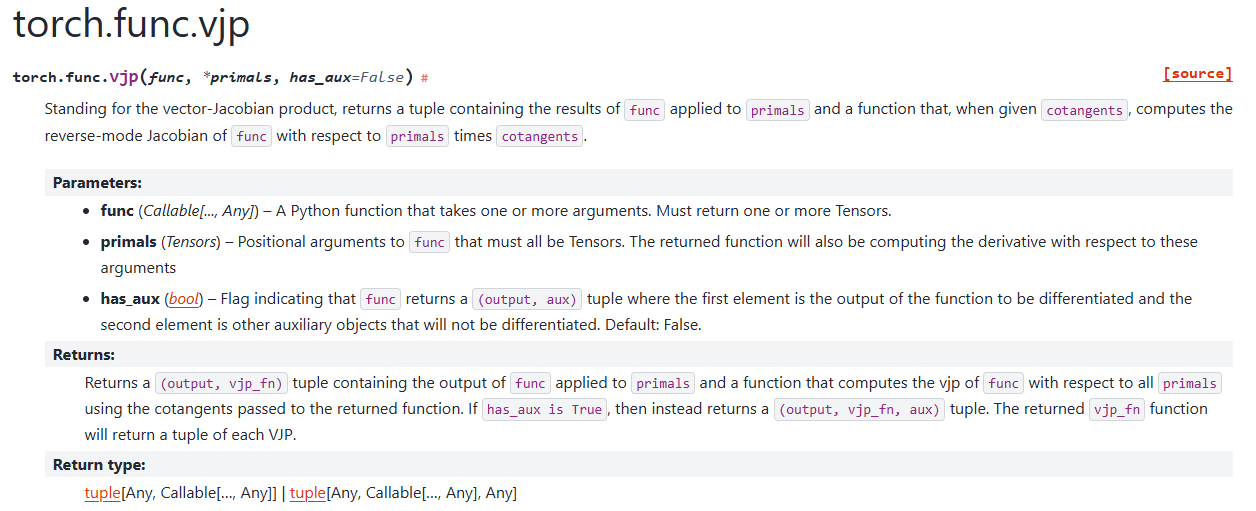
它接受任意可微的函数和它的输入,返回这个函数的前向输出和 vjp 函数对象。vjp 函数对象接受上游梯度,输出下游梯度。torch.autograd.functional.vjp是老一些的接口,它不支持独立地把 vjp 函数作为一个对象拿出来操作,而是将这个过程一体化:
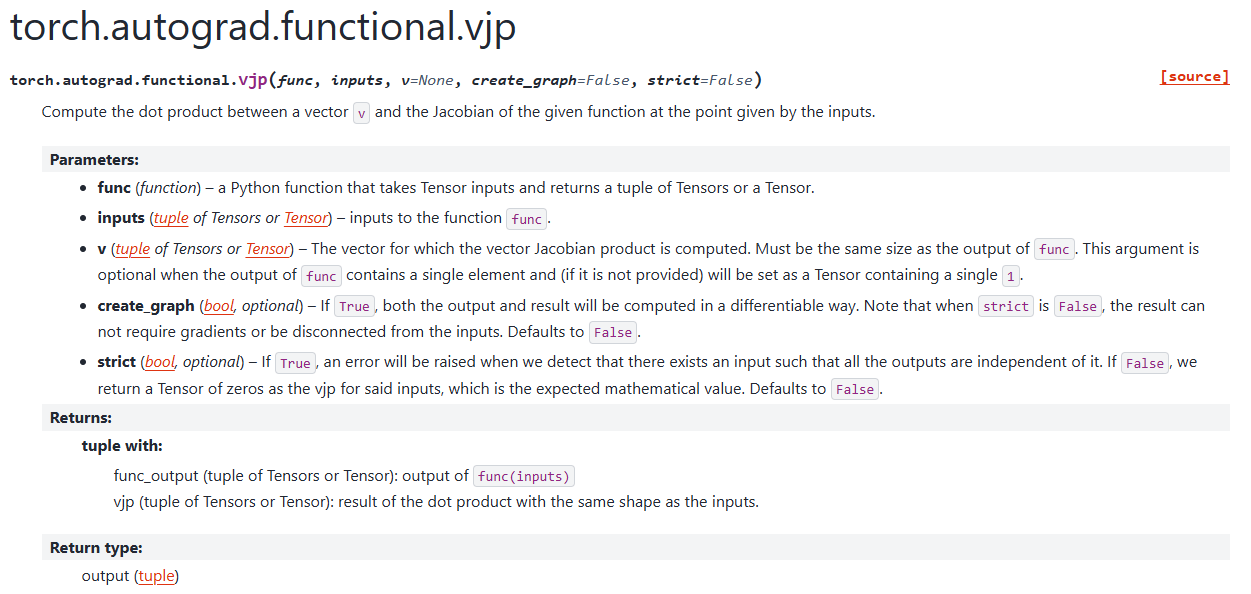
在torch.func.vjp中,取出的 vjp 函数保存了必要的中间激活值,这对于反向的计算过程是必须的。比如上面的例子中,更严谨的写法应该是:
vjpx(∂y∂L)=∂W∂L.
如果输入x本身发生了变化,vjp 函数也需要重新替换。



Comments NOTHING