因为这门课程内容比较多,按照春夏学期分开来写。上半学期还有很多坑没填上,后面会补上的(会的吧)
二编:后半部分一些关于有限元方法和 ODE/PDE 数值求解的东西可能不会补了,别的应该会补的。
Lec 1-2. 线性系统的直接求解
矩阵基础
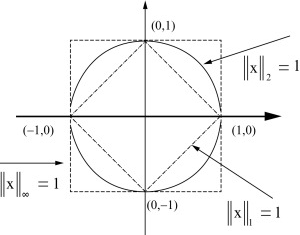
对向量范数而言,在 Cn 上,所有的向量范数都是互相等价的,即它们之间至多差距为常数倍,常数依赖于 n。具体来说,
\begin{align}
||x||_{2} \leq ||x||_{1} \leq \sqrt{ n }||x||_{2}, \\
||x||_{\infty} \leq ||x||_{2} \leq \sqrt{ n }||x||_{\infty}, \\
||x||_{\infty} \leq ||x||_{1} \leq n||x||_{\infty}.
\end{align}
利用柯西不等式不难证明。向量范数的范围之间存在比较直观的几何关系,如下图。
矩阵的诱导范数原始定义为 ∥A∥p=max∥x∥p=1∥Ax∥p。一般常见的范数为 1-范数,2-范数(谱范数),Frobenius 范数(不是诱导范数)和无穷范数。这些范数除了诱导范数的原始定义之外,均有更容易计算的等价定义,此处我们逐个给出证明。这些内容不在本节讲义中,但是在后面会用到。
#theorem
∥A∥1=maxj∑i=1m∣aij∣,又称列和范数。
证明:我们首先证明 ∥A∥1 的上界。我们假设 ∥Ax∥1=∥A∥1,∥x∥1=1,并将其写成列和形式,得到
∥A∥1=∥Ax∥1=∥∥∥∥∥j=1∑nxjAj∥∥∥∥∥1≤j=1∑n∣xj∣∥Aj∥1≤Mj=1∑n∣xj∣=M.
其中 Aj 是 A 的第 j 列,M=maxj∥Aj∥1=maxj∑i=1m∣aij∣。
接下来,我们证明该上界能够取到。实际上取 x=ek 即可,假设在 j=k 时以上最大值取到。QED
#theorem
∥A∥∞=maxi∑i=1n∣aij∣,又称行和范数。
证明:证明思路与上一个类似,只不过这次我们要拆成行表示。我们依然先证明上界:
∥A∥∞=∥Ax∥∞=imax∣⟨Ai,x⟩∣.
其中 Ai 为 A 的第 i 行。假设 max 成立时有 i=k,则有
∥A∥∞=∣⟨Ak,x⟩∣≤u=1∑n∣aku∣∣xu∣≤u=1∑n∣aku∣.
因此,无论 k 实际上取多少,总是有
∥A∥∞=u=1∑n∣aku∣≤imaxj=1∑n∣aij∣.
接下来,我们证明该上界能够取到。假设 ∀i,∑j=1n∣aij∣≤∑j=1n∣atj∣,此时构造 x,使得
xj={1,−1,atj>0,atj≤0.
即可取到。QED
#theorem
∥A∥2=σ1。
证明:∥Ax∥22=∥UΣVx∥22=∥UTUΣVx∥22=∥ΣVx∥22=∑i=1rσi2⟨vi,x⟩2。由于 vi 构成正交基,所以
∥Ax∥22=i=1∑rσi2ui2≤i=1∑rσ12ui2=σ12.
以上等号在取 x 为第一右奇异向量时成立。QED
#theorem
∥A∥F2=∑i=1rσi2。
证明:容易证明 ∥A∥F2=Tr(ATA),直接按迹的定义展开即可。这也是 Frobenius 范数的重要性质。由此可以得到
∥A∥F2=Tr(ATA)=Tr(VΣ2VT)=Tr(i=1∑rσi2viviT)=i=1∑rTr(σi2viviT).
注意到
Tr(viviT)=j=1∑nvj2=∥vi∥22=1.
即可得证(或者利用迹的轮换性质也可以)。QED
从上面还可以得到一个恒等式,即 Tr(ATA)=Tr(AAT)=∑i=1rσi2。另外一个恒等式也顺便写在这里:
#theorem
Tr(A)=∑i=1nλi,其中 λi 为矩阵的特征值。
证明:假设 A 可对角化,则
Tr(A)=Tr(PΛP−1)=Tr(P−1PΛ)=Tr(Λ)=i=1∑nλi.
在不假设 A 可对角化的前提下,也可以通过特征值的定义来证明。比较繁琐,懒得写了。再简单扩展一下,还有一个非常类似的常见结论:
#theorem
det(A)=∏i=1nλi。其中 λi 为矩阵的特征值。
证明:根据特征多项式的定义和代数基本定理,
det(λI−A)=(λ−λ1)(λ−λ2)…(λ−λn).
代入 λ=0 即可得到。
矩阵的各种常见范数以及 Frobenius 范数之间也存在相互等价的关系。具体的关系和证明,见下方矩阵条件数的章节。
当一个实方阵能够对角化时,它可以进行特征值分解;当它不可对角化时,我们知道它一定有 Jordan 标准形。在计算中,比 Jordan 标准形在数值上更友好的是 Schur 标准形。
对于任意的复方阵,均存在 Schur 分解,其形式为
A=UTU∗.
其中,U 是酉矩阵(正交矩阵),T 是一个上三角矩阵,且其对角元对应于矩阵的所有特征值。在实数域内,也存在 Schur 分解对应的形式,此时 T 为准上三角矩阵(Quasi-), 定义为对角块为1×1或者2×2规格的类似上三角阵,其中1×1对应于实特征值,2×2对应于一对共轭的复特征值。
在一个方阵中,对角占优矩阵指的是∣aii∣≥∑i=1,i≠jn∣aij∣(∀i)。不取等号时,称为严格对角占优。严格对角占优矩阵是可对角化的。
LU 分解及变体
LU 分解指的是将一个方阵分解成 A=LU 的形式,其中 L 为下三角矩阵,U 为上三角矩阵。LU 分解不唯一,显然,在其中插入任意的 DD−1 不会影响结果。一般规定 L 为单位下三角(主元都为 1)来确保分解的唯一性。LU 分解是高斯消元的一种表现形式;因此,即使对于一个可逆的方阵,LU 分解也不保证存在,因为在消元的过程中可能遇到主元为零或者接近零的情况,前者不可求解,后者工程上不稳定。此时需要重新进行主元选择的过程,列交换代表两个变量的顺序交换,行交换代表两个方程的顺序交换。对于一个可逆矩阵,总是存在 PA=LU,其中 P 为代表行交换的排列矩阵。
A 存在 LU 分解的充分必要条件是任意阶顺序主子矩阵均可逆(顺序主子式均不为 0)。
LU 分解的一个等价写法是 LDM 分解,即 A=LDM−1,其中 L 和 M 均为单位下三角矩阵。
在 A 对称的条件下,如果 LU 分解存在,由分解的唯一性,得到 A=LDLT,称为 LDL 分解。LDL 分解存在的充分必要条件是 A 的所有顺序主子式均不为零,没有更简单的条件。对于任意对称矩阵,并不能保证存在置换矩阵,使得 PAPT 存在 LDL 分解。在 D 的对角元均为正数的前提下,我们可以对它开平方,并吸收到 L 中,得到 A=LLT 的形式,称为 Cholesky 分解。Cholesky 分解存在的充分必要条件是 A 对称正定。
在 LU 分解存在的情况下,可以将方程 Ax=LUx=b 转换为 Ly=b,Ux=y 进行求解。上下三角矩阵均可以使用逐行代入的方法解出。
LU 分解自身的求解最原始的方法是高斯消元法,即每次通过一个行变换进行消元,得到上三角矩阵;再将所有的行变换矩阵的逆相乘,得到下三角矩阵。在遇到主元为零的情况下时,需要重新选择主元。两个常见的方式是:
显然前者的代价更大,但在理论上更稳定,因为存在同一列中剩下的主元全部为零(或接近零)的情况,此时 GECP 仍然可以求解。实践上,两者的稳定差不多。
另外一种更直接的求法是将 L 和 U 的元素写成待定系数,直接求出它们的元素。U 的第一行和 L 的第一列是可以直接得到的,随后可以求解第二行和第二列,以此类推。这种方法称为 Doolittle 方法。
Cholesky 分解可以使用与 Doolittle 方法相同的方式进行求解。
对于非正定的矩阵,原始形式的 LDL 分解常常导致接近零的对角元,从而导致不稳定。更常见的是 LDL 的扩展版本。Aasen 算法导致的形式是
PAPT=LTLT.
其中 L 为单位下三角矩阵,T 为一个3-对角矩阵,即对角线以及上方一条线、下方一条线上有非零元素。在求解时,通常先将 TLT 合并成一个 Hessenberg 矩阵(即上三角区域加上下方对角线上有非零元素的矩阵),从而将右侧变成 LH。然后将其系数化。由于 Aasen 的分解形式中有多余的自由度,L 的第一列通常直接被规定为 e1,即对角元外其他元素均为零。之后,就可以逐个进行求解。
分块 LDL 导向的形式与与 Aasen 算法一致,但是 T 矩阵被替换为一个准对角矩阵(quasi-diagonal),即对角元素包含 1x1 的标量和 2x2 的矩阵。
矩阵扰动 & 条件数
对于线性系统Ax=b,我们考虑在A和b经历少量扰动时,所得的解x的变化。考虑以下方程:
(A+δA)(x+δx)=b+δb.
利用 Ax=b,解出
δx=−A−1δAx+A−1δb.
两边取范数,利用三角不等式和诱导范数的相容性(柯西不等式),以及 ∣∣b∣∣≤∣∣A∣∣∣∣x∣∣,得到
∣∣x∣∣∣∣δx∣∣≤(∣∣A∣∣∣∣A−1∣∣)(∣∣A∣∣∣∣δA∣∣+∣∣b∣∣∣∣δb∣∣).
规定条件数为 κ(A)=∣∣A∣∣∣∣A−1∣∣,该数决定了系数的扰动和结果的扰动之间放大比例的上限。根据它的定义,有 κ(A)≥1。当条件数大时,称 A 是病态的,反之称为良态的。病态和良态反映了这个线性求解问题的数值稳定程度。
值得一提的是,问题的病态/良态和算法的病态/良态是不同的。良态的算法不能在病态的问题上产生稳定的结果。
在二范数下,因为矩阵二范数等于最大奇异值,所以条件数等于最大特征值与最小特征值的比(逆的最大奇异值就是原来的最小奇异值,根据 SVD 的定义容易得到)。这也可以视为该线性变换作用在单位球上导致的超椭球的拉伸率。
在不同的常见范数下,条件数是等价的,即有常数倍的差距。为了证明这一点,我们先证明矩阵范数之间的等价性。在 Lec 1 中,我们证明了向量范数之间的等价性,实际上矩阵范数的等价性可以直接从向量范数之间的等价性得到。具体来说,我们有
\begin{align*} \|A\|_2 &\le \|A\|_F \le \sqrt{n} \|A\|_2, \\ \max_{i,j} |a_{ij}| &\le \|A\|_2 \le \sqrt{mn} \max_{i,j} |a_{ij}|, \\ \frac{1}{\sqrt{n}} \|A\|_\infty &\le \|A\|_2 \le \sqrt{m} \|A\|_\infty, \\ \frac{1}{\sqrt{m}} \|A\|_1 &\le \|A\|_2 \le \sqrt{n} \|A\|_1. \end{align*}
我们以最后一个为例进行证明。对于左边的不等式,有
∥A∥1=∥Ax∥1≤√m∥Ax∥2≤√m∥A∥2∥x∥2.
因为 ∥x∥1=1,所以 ∥x∥2≤∥x∥1=1。代入上式即可得证。对于右边的不等式,有
∥A∥2=∥Ax∥2≤∥Ax∥1≤∥A∥1∥x∥1.
因为 ∥x∥2=1,所以 ∥x∥1≤√n∥x∥2=√n。代入上式即可得证。
其余诱导范数相关的不等式均可以通过类似的方式证明。至于 Frobenius 范数,由于二范数是矩阵的最大奇异值,而 ∥A∥F=√σ12+σ22+…+σr2,所以
∥A∥2≤∥A∥F≤√r∥A∥2≤√min(m,n)∥A∥2.
至于第二个不等式,因为 ∥Ax∥2≤∥A∥2∥x∥2,我们可以通过代入单位向量来证明二范数比任意一个元素的绝对值都大。后半部分可以直接从第一个不等式中利用 Frobenius 的范数得到。
在此基础上,容易证明
\begin{align*} \frac{1}{n}\kappa_2(A) &\le \kappa_1(A) \le n\kappa_2(A), \\ \frac{1}{n}\kappa_\infty(A) &\le \kappa_2(A) \le n\kappa_\infty(A), \\ \frac{1}{n^2}\kappa_1(A) &\le \kappa_\infty(A) \le n^2\kappa_1(A). \end{align*}
只要把矩阵范数的等价性代入即可证明。因此,一个矩阵如果在一个范数下是病态的,在另一个范数下基本也是病态的。
行列式和条件数没有关系。即使行列数显著大于 0(明确可逆),它的条件数也可能是病态的。反之,良态的矩阵通常有比较小的行列式。
特征值也和条件数没有关系。
QR 分解
QR 分解求解的目标是超定问题,即 A∈Rm×n,m>n。如果是有唯一解的问题,A 为方阵,使用上面的 LU 分解就够了。在超定问题中,求解的目标不再是方程的解,它是无解的;超定问题求解的是最小二乘问题。虽然也可以使用正规方程求解,但是 QR 分解在数值上更稳定。
QR 分解的数学形式是
A=QR,Q∈Rm×m,R∈Rm×n.
其中 Q 为列正交矩阵,R 为上三角矩阵。话虽如此,因为 m>n,所以 R 的下半部分会有很多零元素。我们可以像 SVD 一样将它写成精简的形式:
A=(Qm,nQm,m−n)(Rn,n0m−n,n)=Qm,nRn,n.
所以,精简的形式是
A=QR,Q∈Rm×n,R∈Rn×n.
我们重新写出最小二乘的形式:
min∥Ax−b∥2.
代入 QR 分解,得到
min∥Ax−b∥2=min∥QRx−b∥2.
进行正交变换不影响模长,所以
min∥QRx−b∥2=min∥Rx−QTb∥2=min∥Rx−c∥2.
注意,这里使用的是完整的形式,而不是精简的形式;精简形式的 Q 不是方阵,不能代表正交变换。现在,我们将它延续精简形式的方法裂开,得到
∥Rx−c∥2=∥(Rn,n0m−n,n)x−(c1c2)∥2=∥Rn,nx−c1∥2+∥c2∥2.
其中 c1=Qm,nTb,c2=Qm,m−nTb。注意到,前一项是可以最小化的,通过求解 Rn,nx=c1 即可;后一项和变量无关,即为最小二乘的残差项。
从几何上来理解,Ax 指的是在将 A 的列向量加权组合,即 A 的列空间。如果 b 根本不在这个空间中,残差就不可能达到零。我们能做的就是在 A 的列空间中调整,使残差最小。显然,当残差向量与 A 的列空间垂直时,残差达到最小值。
QR 分解也可以用来解仅有唯一解的情况。我们知道,正规方程的唯一解是
x=(ATA)−1ATb.
代入 QR 分解之后,得到
x=(RTR)−1RTQT=R−1QT.
形式和超定的情况其实是一样的,只不过超定时使用的是精简的矩阵。
QR 分解可以通过一些方法得到。下面介绍三种。
Gram-Schmidt 过程
Gram-Schmidt 过程用于在给定一组 {x1,x2,…,xn} 的情况下,将它们变成一组单位正交基 {q1,q2,…,qn}。具体过程是:
-
取 x1,将其单位化,得到 q1。
-
取 x2,从其中扣掉在 q1 上的投影,然后单位化,得到 q2。
-
取 x3,从其中扣掉在 q1 和 q2 上的投影,然后单位化,以此类推。
所求得的 (q1,q2,…,qn) 就是我们想要的 Q。再利用 QTA=R 即可得到 R。
需要注意的是,Gram-Schmidt 并不一定能够产出 n 个单位正交基。当某个 xi 在扣完前面的分量之后变成零向量时,它应该被跳过,不进入 Q 矩阵。因此,Gram-Schmidt 得到的实际上是精简版的 QR 分解。更进一步地,对于 A∈Rm×n,m>n 而言,Gram-Schmidt 最多拆出 n 个正交基,是无法填满 Q∈Rm×m 的列的。为了得到剩下的列,一个最直接的办法就是把 A 扩展成 (A,A~),然后再进行 Gram-Schmidt 过程,使其能够产生 m 个线性独立的基。最保守的选择是 A~=I,这样能够保证扩展后的矩阵秩达到 m。
将扩展后的矩阵正交化得到的结果拆分为 Q=(Q1,Q2),其中 Q1 是原本的 A 产生的基,Q2 是扩充后产生的基。Q1 和 Q2 的列空间在 Rm 中互为正交补。Q1 的列空间是 A 的列空间,Q2 的列空间是 AT 的零空间。前者是解所在的空间,后者是残差所在的空间。
快速回忆:对于 A∈Rm×n,A 的列空间与 AT 的零空间在 Rm 中构成正交补,A 的行空间与 A 的零空间在 Rn 中构成正交补。
Gram-Schmidt 还有一个更简洁的形式:
qi=∥Pixi∥Pixi,Pi=I−Qi−1Qi−1T.
其中 Qi−1=(q1,q2,…,qi−1)。
Householder 变换
Householder 变换的形式是
H=I−2uTuuuT.
变换 Hv 可以将 v 关于一个镜面映射到镜面的另一边。这个镜面是一个通过原点的超平面,超平面的法方向为 u。Householder 变换是一个正交变换。
基于 Householder 变换进行三角化的思想是:从第一列 x1 开始,通过镜面映射,将对角线以下的部分变成零。当进行到第 k 列时,我们关注的是它从对角线往下的 m−k+1 个分量构成的子向量,将它记为 x。我们需要构造一个镜面,将它映射到坐标轴上,从而将除了第一维之外的分量都变成零。几何理解如下。
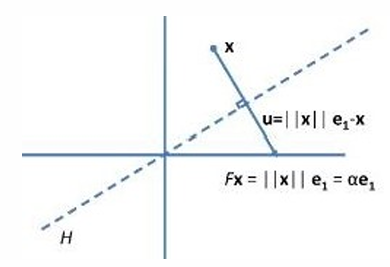
所以我们希望构造一个映射,从 x 映射到 ∥x∥e1(正交映射不改变模长)。显然,这个超平面的法向是 ∥x∥e1−x;由此,我们获得了所需要的 Householder 变换矩阵 H。
在矩阵整体上,我们构造这样的矩阵。
Qk=(Ik−1,k−10m−k+1,k−10k−1,m−k+1Hm−k+1,m−k+1).
将其左乘于 A,得到
(Ik−1,k−10m−k+1,k−10k−1,m−k+1Hm−k+1,m−k+1)(Ak−1,k−1Am−k+1,k−1Ak−1,n−k+1Am−k+1,n−k+1)=(Ak−1,k−1HAm−k+1,k−1Ak−1,n−k+1HAm−k+1,n−k+1).
注意到左下角的分量在进行到第 k 步时已经全部为零,经过 Householder 变换之后还是零。由此即可得到 QR 分解所需的全部内容。
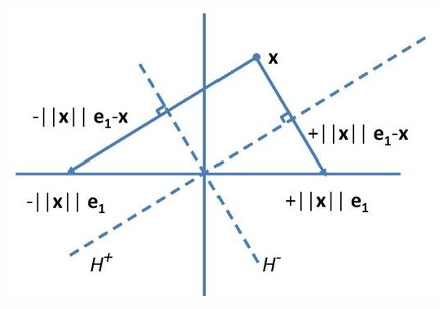
注意到 Householder 变换时其实有两个选择 ∥x∥e1 和 −∥x∥e1,为了数值稳定性,一般取离原始的 x 较远的那一个,等价于选择 u=sign(x1)∥x∥e1+x 作为法向。几何理解如下图。
Householder 变换用于 QR 分解的主要优势在于数值稳定性。
Givens 旋转
其实指的就是
(cosθsinθ−sinθcosθ)(ab)=(r0).
将单位矩阵的 (i,i),(i,j),(j,i),(j,j) 四处填入以上元素,即可对 (i,j) 两行应用以上变换。Givens 旋转一次仅可以消去一个非零元素,其自身仍然是一个正交变换。同时,由于任意两行的线性组合不会将共同的零元素变成非零元素,因此能够保持前序列的零元素不变。细节略去。Givens 旋转可以用于求解稀疏矩阵的 QR 分解,因为它允许非常细粒度的操作。
LU 分解,QR 分解(gram schmidt,householder,given rotation)
迭代解法
Lec 3. 线性系统的迭代求解
将 Ax=b 转换为一个更加容易求解的近似方程 Mx=b,在解得 Mxi=b 之后,我们知道残差为
r=b−Axi.
我们希望继续求得修正量 Δx,使得
AΔx=b−Axi.
这个方程仍然是难以求解的,因此我们仍然使用近似矩阵代入,得到
xi+1=xi+Δx=xi+M−1(b−Axi).
于是我们就得到了一个迭代形式。迭代形式的要求是近似方程容易求解,且收敛速度够快。
假设 A 可逆,称
A=M−N.
为 A 的一个矩阵分裂,其中 M 可逆。于是原始方程等价于
Mx=Nx+b.
将左侧视为下一步迭代,得到
xi+1=M−1Nxi+M−1b.
一个常见的分裂形式是
A=D−L−U.
其中 D 是 A 的对角成分,−L 是严格下三角成分,−U 是严格上三角成分。
Jacobi 迭代 & Gauss-Seidal 迭代
取 M=D,N=L+U,得到 Jacobi 迭代的形式
xi+1=D−1(L+U)xi+D−1b.
注意,L 和 U 是取过负号的。
取 M=D−L,N=U,得到 Gauss-Seidal 迭代的形式
xi+1=(D−L)−1Uxi+(D−L)−1b.
这个形式涉及到三角矩阵的逆,一般不这样计算。更常见的形式是
Dxi+1=Lxi+1+Uxi+b.
尽管左右都具有 xi+1,但是 L 是严格下三角的,所以仍然可以直接解出。不过 xki+1 的解出将要依赖于 x1i+1,x2i+1,…,xk−1i+1,即所有分量不能并行解出,必须进行顺序地求解。Gauss-Seidal 迭代相比 Jacobi 迭代利用了更新的信息,但并行性更弱。
SOR 是 Gauss-Seidal 的改良,简单来说就是在 Gauss-Seidal 的旧值和新量之间使用动量,不过是用于外插加速收敛。具体不推了,反正形式是
(D+ωL)xi+1=((1−ω)D−ωU)xi+ωb.
SSOR 不看了,略过。
迭代法的误差传播
定常迭代法(即迭代规则与 i 无关)xi+1=Gxi+g 在收敛时应当满足
x∗=Gx∗+b.
所以误差的传播为
ei+1=xi+1−x∗=(Gxi+b)−(Gx∗+b)=G(xi−x∗)=Gei.
所以收敛性由 Gn 决定。显然,这取决于 G 的谱半径,即绝对值最大的特征值。当 ρ(G)<1 时,迭代法收敛。同时,ρ(G) 越小,收敛速度越快。
Richardson 迭代
Richardson 迭代指的是
xi+1=xi+ω(b−Axi).
或者,我们也可以从类似矩阵分裂的角度来看待它。令 A=I−(I−A),得到矩阵分裂的形式
xi+1=(I−A)xi+b.
引入一个额外的步长系数,得到
xi+1=(I−ωA)xi+ωb.
即 Richardson 迭代。Richardson 的误差传递矩阵 G=(I−ωA)。
#theorem
若 A 为对称半正定矩阵,则 Richardson 迭代法的收敛条件为 ω<λmax2。
证明:A 的特征值均非负,因此 0≤λmin≤λmax。因此,收敛条件为
ρ(I−ωA)=imax∣1−ωλi∣≤1.
展开为 −1≤1−ωλi≤1,即 0≤ωλi≤2。上式对一切 λi 成立,得到 ω≤λmax2(要求最大特征值不为 0,或者直接要求 A 为对称正定矩阵)。QED
#theorem
Richardson 迭代法在取 ω=λmin+λmax2 时,收敛速度最快,收敛速度为 ρ=κ(A)+1κ(A)−1。
证明:收敛速度最快,即谱半径最小:
ωminimax∣1−ωλi∣.
在几何上,1−ωλ 是一条截距固定为 1 的直线,ω 控制它的斜率。在扫过 [λmin,λmax] 的区间时,∣1−ωλ∣ 的最大值只有可能在两个端点取到,并且他们二者的最大值的最小值在零点恰好落在 2λmin+λmax 时取到(几何上还是比较直观的)。因此
\begin{align}
1-\omega_{opt} \frac{\lambda_{min}+\lambda_{max}}{2}=0, \\
\omega_{opt}=\frac{2}{\lambda_{min}+\lambda_{max}}.
\end{align}
此时代入 λmin 或者 λmax,得到
ρ=λmax+λminλmax−λmin=κ(A)+1κ(A)−1.
QED
显然,条件数越小,收敛越快;反之,收敛越慢。
Richardson 迭代和梯度下降具有相同的形式。假设 A 对称正定,我们构造函数
f(x)=21xTAx−bTx.
对于梯度下降,有
∇f(x)=Ax−b.
取一个定步长梯度下降,即可得到 Richardson 迭代的形式。在上篇中,我们曾经提到最优的梯度下降是变步长方法,即这里说的非定常方法。记反梯度方向 r=b−Axi,我们有
αminf(xi+αr).
代入得到
\begin{align}
f(x^i+\alpha r)&=\frac{1}{2}r^TAr \cdot \alpha^2+\left( \frac{1}{2}(x^i)^TAr+\frac{1}{2}r^TAx^i-b^Tr \right)\alpha+C \\
&=\frac{1}{2}r^TAr \cdot \alpha^2+((x^i)^TAr-b^Tr)\alpha+C \\
&=\frac{1}{2}r^TAr \cdot \alpha^2-(b-Ax^i)^Tr\cdot \alpha+C \\
&=\frac{1}{2}r^TAr \cdot \alpha^2-r^Tr\cdot \alpha+C.
\end{align}
其中 C 为与 α 无关的量,第二个等号由对称矩阵性质得到。这是一个二次函数,因此最优步长为
αopt=rTArrTr.
利用最优步长的性质,可以证明最优步长的梯度下降减少误差的速度至少和 Richardson 一样快。这是显然的。
Chebyshev 迭代
Chebyshev 迭代法是一种二阶非定常方法。本质上,它也可以看作是 Richardson 迭代法在非定常条件下的推广。我们现在允许步长系数 ω 在每一步之间变化,此时的误差传递矩阵将变成
ek=(I−ωk−1A)(I−ωk−2A)…(I−ω0A)e0.
我们知道,此时的误差传递矩阵对应的特征值是
i=1∏k−1(I−ωiλj).
因此,为了减少误差,需要让以上多项式在 [λmin,λmax] 上的最大绝对值最小。这符合 Chebyshev 多项式的性质,因此系数由 Chebyshev 多项式决定。
利用 Chebyshev 多项式的迭代形式,更常见的形式是
xk+1=ρk+1(xk+γ(b−Axk))+(1−ρk+1)xk−1.
其中
ρ1ρ2ρk+1=1=2−σ22=1−4σ2ρk1.(k≥2)
预条件 Preconditioning
预条件是大多数迭代法之前的一个通用预处理步骤。因为多数的迭代法都会在 A 的条件数较大时收敛缓慢,预条件法通过一个附加的线性变换将其重新转换为一个良态的矩阵,然后求解。具体来说,预条件法引入一个预条件子 M,使得
M−1Ax=M−1b.
该方程与原方程等价,如果 M−1A 更加良态,这个方程就会更好求解。因此,预条件子需要满足以下条件:
预条件子有两个极端。其一为 M=A,此时预条件后的矩阵就是单位阵,但 M−1b 无法简单计算。另一个极端是 M=I,此时 M−1b 能够简单计算,但是矩阵不会因此更加良态。
预条件子有很多选择,这里不一一列举。
子空间方法
子空间方法指的是将 Rn 的求解空间缩小到一个维度更小的子空间中,子空间的维度通常远小于 n,从而转换为更快地求解近似解的方法。定义求解空间为 K(搜索空间),我们通常还需要定义一个约束空间 L,当残差向量与 L 正交时,我们认为此时的解满足近似最优。在 QR 分解中可以看到 K=L 时的几何理解。
Krylov 子空间由一个矩阵 A∈Rn×n 和一个向量 r∈Rn 生成,定义为
Km(A,r)=span{r,Ar,…,Am−1r}.
Krylov 子空间是一系列不断扩张的空间,即 Ki(A,r)⊂Ki+1(A,r)。
为了在 Krylov 子空间中进行求解,我们需要使用 Arnoldi 过程构建它的一组正交基。Arnoldi 过程实际上就是 Gram-Schmidt 过程,只不过每个向量的初始选取不同。第一个向量选取为 v1=r/∥r∥,随后的每一个向量初值选取为前一个基乘上 A,正交化的过程不变,即
hj+1,jvj+1=Avj−i=1∑jhijvi.
其中 hij=⟨Avj,vi⟩。hj+1,j 是归一化系数,写成这样只是好看。利用 delta rule 类似的技巧,将 Avj 放到左边,然后右侧写成矩阵形式,最后遍历 1,2,…,m,得到
AVm=Vm+1Hm+1,m.
这里出现了 m+1 的量,这个量不属于 Km,而是属于 Km+1 的。但为了左侧能够出现所有的 Vm,我们需要把它算出来。然后,我们再把它拆开:
AVm=(Vmvm+1)(Hmhm+1,memT)=VmHm+vm+1(hm+1,memT).
两侧同时左乘 VmT,由于正交性,得到
VmTAVm=Hm.
其中 Hm 是一个上 Hessenberg 矩阵。
现在,我们在仿射空间 x0+Km 中寻找近似解。我们取 Lm=Km,此时称为完全正交方法(FOM)。在得到 Vm 之后,我们将自变量表示为 x=x0+Vmy。我们有根据近似最优条件,我们有
\begin{align}
0&=V_{m}^T(b-Ax)=V_{m}^T(b-Ax^0-AV_{m}y) \\
&=V_{m}^T(r_{0}-AV_{m}y) \\
&=V_{m}^Tr_{0}-H_{m}y.
\end{align}
以此即可解出所需的解。解出后,衡量残差是否达到预期;如果没有达到,扩展到 Km+1 并继续求解。
Lec 5. Sparsity
有的时候,数据本身就是稀疏的;另外一些时候,数据需要转移到其他的表征空间中,才会变得稀疏。还有一些时候,我们希望得到的解是稀疏的。比如,给定一系列国家的特征(人口密度等),并且给定一系列国家的 GDP,我们希望哪些特征是决定 GDP 的主要因素。将其形式化为 Ax=b,其中A指的是所有国家构成的特征矩阵,b指的是 GDP 构成的向量。求解这个方程,即可得到我们需要的解。我们自然不希望得到的解是稠密的(GDP 和所有因素都相关),此时我们就希望得到稀疏的解。
稀疏最小二乘解
回忆到上半学期中最小二乘问题的形式:
xmin∣∣Ax−b∣∣22.
这个方程具有三种解的情况:
-
不存在解满足 ∣∣Ax−b∣∣=0,或者说方程 Ax=b 超定。
-
存在唯一解满足 ∣∣Ax−b∣∣=0。
-
存在多个解满足 ∣∣Ax−b∣∣=0,或者说方程 Ax=b 欠定。
既然我们需要寻找稀疏解,首先它需要有一些解可供选择,因此我们假定方程是欠定的。在欠定的假设下,我们再假设A中没有冗余的约束,即A行满秩。在这种情况下,我们将最小范数最小二乘问题重新写成下面的优化形式:
xmin∣∣x∣∣22,s.t.Ax=b.
将它写成 Lagrange 函数的形式:
L=∣∣x∣∣22+λT(Ax−b).
求解,得到
\begin{align}
\nabla_{\lambda}L=Ax-b=0. \\
\nabla_{x}L=2x+A^T\lambda=0.
\end{align}
由于A行满秩,所以AAT可逆。进而
\begin{align}
\lambda=2(AA^T)^{-1}b. \\
x=A^T(AA^T)^{-1}b.
\end{align}
容易验证,这是最小范数最小二乘问题在行满秩条件下的简化解,代入 SVD 验证不难。
要使得解稀疏,我们不再要求解具有最小的二范数。理想条件下,我们需要使用零范数∣∣x∣∣0作为优化的目标,因为零范数的含义就是向量中非零元素的数量。但是,这个问题是 NP-hard 的,我们只能求解它的近似问题或者使用近似解法。匹配追踪算法是其中一种。
Matching Pursuit
matching pursuit 关注的是零范数优化的一个近似问题:
xmin∣∣Ax−b∣∣2,s.t.∣∣x∣∣0≤S.
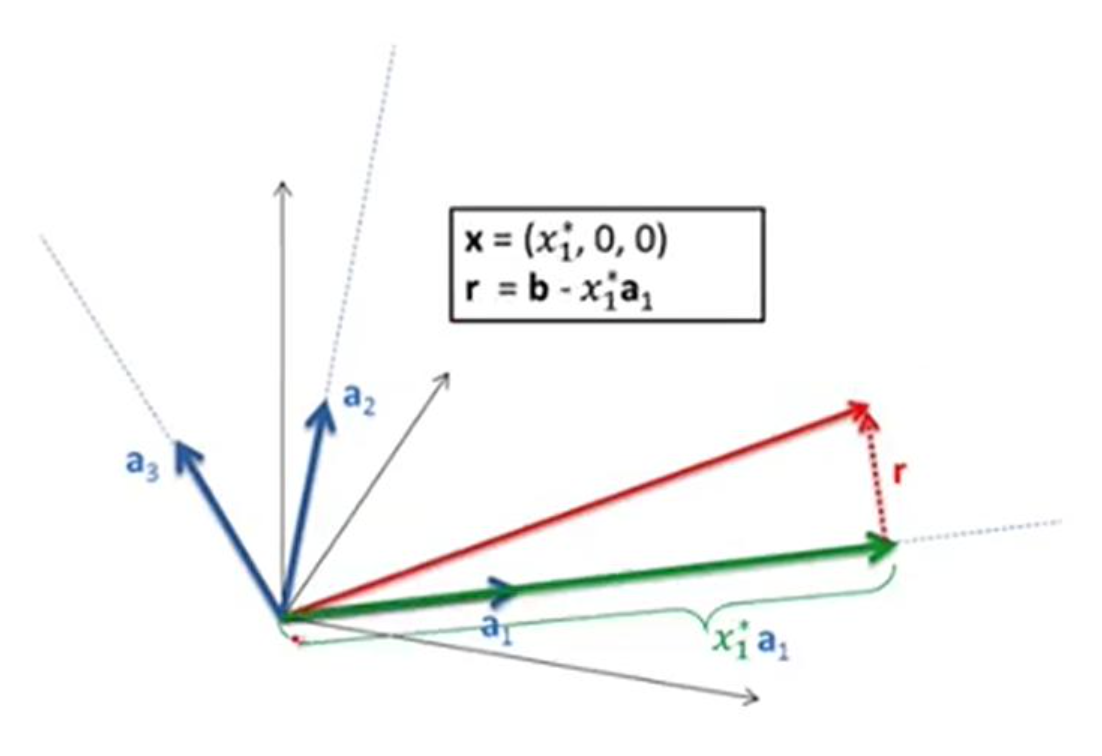
它是一种近似的贪婪解法。对于一个稀疏的x,Ax相当于在非零元的对应位置取出A的列向量,然后进行加和。MP 算法从x=0开始,不断地选择一个新的元素,使其成为非零元,直到达到∣∣x∣∣0=S的约束上限为止。
在每选择一个非零元时,MP 需要使得损失尽可能减小。损失的残差一开始是b。选择非零元就是选择A的列向量,在几何上,如果残差到列向量的投影模长越大,损失减少得就越多。因此,选择投影模长最大的列向量,并计算相应的系数作为x中对应的分量,即可以贪婪的方式完成这个问题的近似解。
Orthogonal Matching Pursuit (OMP) 是 MP 的一种改良算法,它的大致过程与 MP 相同,但是在选定一个新的列,求解对应的系数时,做法有所不同。MP 算法中,每选定一个新的列不会改变之前已经决定的系数,而是根据当前的残差与当前列的投影决定当前的系数。OMP 将重新分配目前所有的系数;将所有选定的列组成矩阵 A∗=[a1,a2,…,at],并求解无约束最小二乘问题 minx∗∥A∗x∗−b∥。我们知道,求解完该问题之后,一定会有 r⊥span(a1,a2,…,at),因此下一步计算残差时,残差与当前所有已选定的列之间的点积都会达到 0,即已被选中者不可能再被选中。OMP 一定能在 S 步内收敛。
Sparsity under L1 Norm
由于零范数是一个求解困难的问题,使用一范数(所有元素的绝对值之和)作为一个近似是不错的选择。我们回到最开始的形式:
xmin∣∣x∣∣1,s.t.Ax=b.
我们使用一个技巧将x拆分成正负两部分,即构造下图所示的变量:
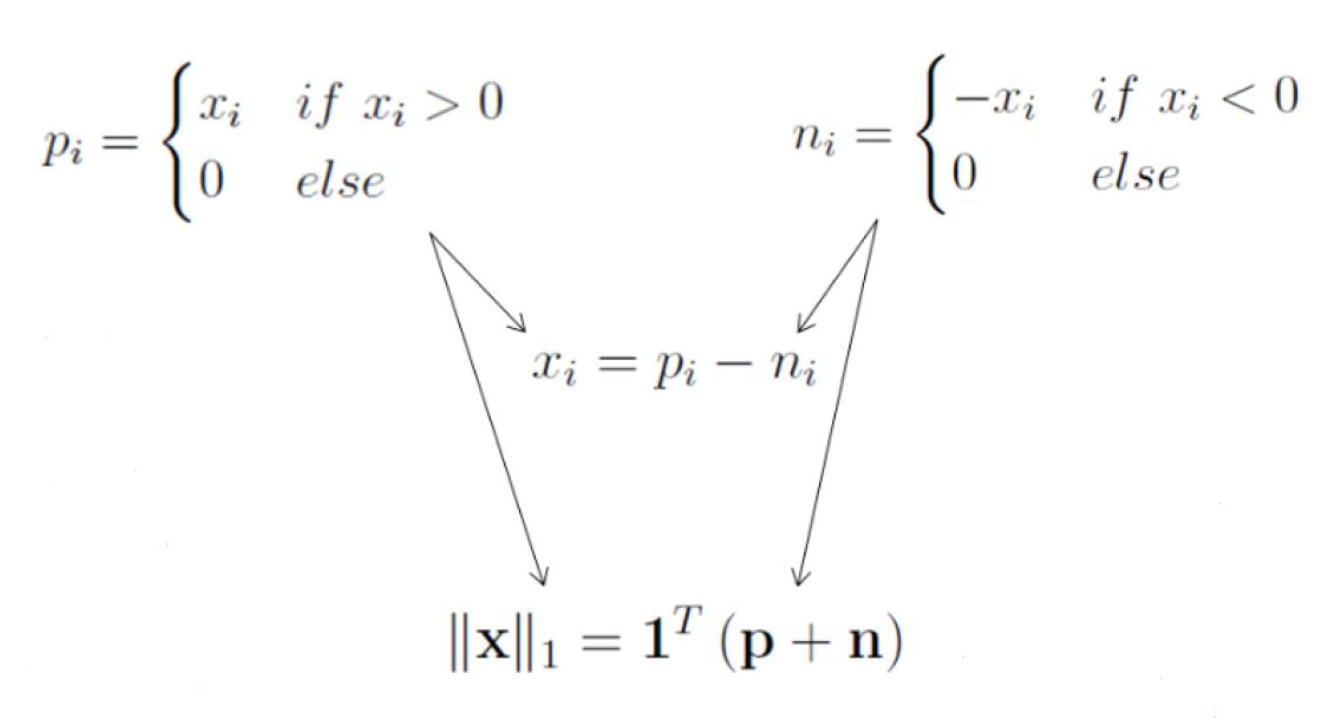
经过这个变换之后,原问题能够转换为一个线性规划问题,从而求解。
Lec 6. Tensor
graph laplacian
Lec 7a. ODE
PDE 大致分为三大类:椭圆方程、双曲线方程和抛物线方程。
differential deep learning on graphs and its applications
初值问题
初值问题通常与时间有关。给定某一个初始时刻的函数状态,求解之后一段时间内的函数状态变化。这指的通常是一阶微分方程,因为一阶方程只需要一个条件进行定解。
考虑一阶微分方程dy/dt=f(t,y(t))。他代表着,给定时间t和当前的函数值y(t),我们能够知道函数值的变化率。
广义欧拉法
欧拉法指的是使用前向查分代替上面的导数,广义欧拉法指的是
yn+1=yn+Δt⋅ϕ.
其中ϕ是与当前和未来相关的一个因子,用于调整离散误差。假设
y(t+Δt)≈y(t)+Δt(Af(t,y(t))+Bf(t+PΔt,y(t)+QΔt⋅f(t,y(t)))).
即ϕ被参数化为当前的导数和某个“未来”的导数的组合,由一组参数(A,B)权衡。对于未来项,为了避免未来值y(t+PΔt)出现在方程中使其成为隐式方程,我们使用类似朴素欧拉法的项y(t)+QΔt⋅f(t,y(t))进行替代。
对近似未来项进行泰勒展开,得到
\begin{align}
&f(t+P\Delta t,y(t)+Q\Delta t \cdot f(t, y(t))) \\
&=f(t, y(t))+P\Delta t \frac{\partial f}{\partial t}(t, y(t))+Q\Delta t \cdot f(t,y(t)) \frac{\partial f}{\partial y}f(t,y(t))+O(\Delta t^2).
\end{align}
代回上式,得到
\begin{align}
y(t+\Delta t)\approx &y(t)+\Delta t(A+B)f(t, y(t))+PB\Delta t^2\frac{\partial f}{\partial t}(t, y(t)) \\
&+QB\Delta t^2f(t,y(t)) \frac{\partial f}{\partial y}f(t,y(t))+O(\Delta t^2).
\end{align}
同时,y(t+Δt)本身有一个泰勒展开:
y(t+Δt)=y(t)+f(t,y(t))Δt+21y′′(t)Δt2+O(Δt3).
其中,
\begin{align}
\frac{d^2y}{dt^2}&=\frac{d}{dt}\left( \frac{dy}{dt} \right)=\frac{d}{dt}(f(t,y(t)))=\frac{\partial f(t,y(t))}{\partial t} \frac{dt}{dt}+\frac{\partial f(t,y(t))}{\partial y} \frac{dy}{dt} \\
&=\frac{\partial f(t,y(t))}{\partial t}+\frac{\partial f(t,y(t))}{\partial y}f(t,y(t)).
\end{align}
将其代入上式,并使以上两个泰勒展开一致,得到三个约束条件:
\begin{align}
A+B=1, \\
PB=\frac{1}{2}, \\
QB=\frac{1}{2}.
\end{align}
因此在满足二阶泰勒展开的情况下,系数中仍然存在自由量。当A=1时,约束不满足,系统退化到朴素欧拉法。当A=21时,得到 Neun 方法,更新因子为当前梯度与近似未来一步的均值。当A=0时,得到改良 Euler-Cauchy 方法,亦称为二阶 Runge-Kutta 方法。更新因子为近似未来半步的梯度。
边值问题
边值问题指的是在给定多个边界条件的情况下进行求解,通常指的是二阶及以上的系统,因为二阶及以上系统才需要多个条件进行定解。
Lec 7b. PDE
Poisson Equation
记 Laplace 算子Δ=(∂x∂,∂y∂)。泊松方程为
Δu=f(x,y).
当f=0时,亦称为 Laplace 方程或者调和方程。保守场(比如静电场)中的高斯定理(电通量的散度与电荷量的等价关系)就是一个泊松方程。
泊松方法可以通过有限元方法求解,即将空间离散化为一个二维的网格:
h2ui−1,j+ui+1,j−2ui,j+h2ui,j−1+ui,j+1−2ui,j=fi,j.
对空间每一点列出方程,联立线性方程组,即可求解。泊松方程解的存在性取决于边界条件
热传导方程
记温度分布为 u(x,y,z,t),热传导方程为
∂t∂u=kΔu.
数值解法为先空间离散化,使得其变为一个关于时间的 ODE。随后使用 ODE 求解法即可。
波动方程
对流扩散方程
频谱法



Comments NOTHING