


这篇文章是计算机应用数学课的报告,当时正在研究 Muon,觉得好玩,就写了。现在看来还有很多写得不到位的地方,但扔了可惜,先端上来吧。
Introduction
这篇报告的内容包括 Muon 优化器的推导,数学性质,以及对其分布式实现的尝试。Muon 优化器是 2024 年由 Keller Jordan 提出的一种优化器,在提出后迅速在大规模的 LLM 上得到验证,是近年来唯一一种(应该是)能够稳定地超越 Adam/AdamW 等传统方法的优化器,亦常见于各类 LLM 训练的 speedrun 中。尽管效果优越,Muon 优化器的理念却并不复杂;Muon 优化器只是对梯度进行了一次正交化,仅此而已。由此,我们可以引申出一系列关于优化问题的有趣视角。另一方面,Muon 优化器是非常特殊的,因为它只适用于二维的稠密矩阵权重,网络中的其他部分必须回退到 Adam 优化器进行优化。了解 Muon 背后的原理对于 Muon 为什么这样设计,以及到底什么地方可以使用 Muon 这样的问题至关重要。
虽然题目上包含了 Implementation,但本文并不会包含 Muon 优化器的实现;相反,我们会在这一部分论述为什么 Muon 的分布式实现在当前的 Pytorch 框架下几乎是不可能的。其实倒霉孩子因为在使用 Muon 进行分布式训练的时候爆显存了,所以想着干脆自己魔改一个,顺便作为报告的一部分;但在大致阅读了 Pytorch FSDP 的框架代码之后意识到这一点很难做到,所以放弃了。我们会说明 Muon 在计算上相比传统的优化器有何特殊之处,使得它难以在传统并行框架下实现,且社区中至今没有统一的实现版本。
Muon 优化器本身并没有正式的 paper,其原型是一篇 blog。在国内,在引入 Muon 优化器中起到核心作用的是来自 Kimi 的苏剑林,Kimi 亦是 scalable Muon 背后的重要推手。这篇报告整理自 Keller Jordan 和苏剑林等人的一系列相关 blog、苏剑林的文章,以及一些 paper。
Formulation of Muon Optimizer
事实上,Muon 优化器并没有一个统一的形式;即使是最基础的 Muon 也有至少四种变体。在这里,我们先给出最早也是最简单的,来自 Keller Jordan 的版本:
其中 为梯度, 为动量。 是一个二维的权重矩阵。从形式上来看,Muon 的优化过程就是在含动量的 SGD 的基础上,在最终应用更新量之前,对更新量进行了一个额外的操作。而这个操作,在实际实现中体现为 NewtonSchulz5 迭代过程,就是我们需要讨论的 Muon 的核心动机。
Orthogonalization of Gradients
Muon 的出发点非常简单:在每一步更新的时候,尽量保证更新量是一个半正交矩阵。换言之,我们需要寻找
\text{Ortho}(G) = \arg\min_{O} \left\{ \|O - G\|_F^2 : O O^T = I \text{ 或 } O^T O = I \right\}.
这里我们直接使用了梯度的记号,暂时忽略动量的存在。一般来说,这里被正交化的东西是动量。NewtonSchulz5 迭代所得到的就是上述问题的近似解。关于为什么要让更新量变得半正交,Muon 的原作者给了两种回答:
-
我不知道,反正它就是有用
-
在基于 Transformer 的网络中,Adam 或者 Momentum SGD 对二维权重带来的更新通常有比较高的条件数和比较低的秩。这意味着权重的更新方向被少数几个方向主导。正交化可能使得那些比较稀有的更新方向得到增强,这可能是有利于优化的
关于 Muon 的优化行为的详细理解,我们放到下一章。现在我们先关心如何找到这个 。首先,从数学的角度出发,这个问题可以使用 SVD 给出解析解。
如果矩阵 半正交,那么 。
Proof. 。
记 SVD 分解 ,正交化问题的一个解为 。
Proof. 我们对目标函数进行变换:
其中,中间一项含义为两个矩阵的 Frobenius 内积,即两个矩阵逐点相乘再求和,或者等价地,。根据上面的推论,第一项是常数,第三项与优化目标无关,因此最小化目标函数等价于最大化 。
将 SVD 分解形式 代入,得到
第二个等号成立是因为迹的轮换不变性。最后一个不等式成立是因为 半正交,因此其谱范数 ,由柯西不等式和谱范数的定义得到
在得到上界之后,我们证明这个上界可以取到。构造 ,代回原式,得到
进一步地,我们还可以证明当 满秩时, 是唯一解,而不满秩时则不是。这段证明我们在此略去,反正 SVD 是它的一种解法。
实践上,Muon 没有直接使用 SVD 的解法来获得 ,因为 SVD 的计算代价太大了。NewtonSchulz5 解法被采用的重要理由是它能够很快地执行,并且它能够在 bfloat16 下稳定地执行,不会出现数值问题。
Newton-Schulz 迭代的引入是一个比较微妙的过程。接下来,我们先介绍矩阵符号函数(msign),并通过它的性质启发式地猜出 Newton-Schulz 迭代的形式。然后,我们再说明 Newton-Schulz 迭代如何确实能够收敛到 ,以及其中的超参数是如何选择的。
Sign of a Matrix
上面的 Muon 写法并不是唯一的。在苏剑林的文章中,使用的是这样的记法:
其中的 msign 为矩阵符号函数。我们在上一节中求得的 实际上就是 的矩阵符号:
msign 函数有以下性质:
。
Proof. 对于一个可对角化的矩阵 ,其平方根定义为 ,其中 中的值定义为特征值的算术平方根。其实严格定义上矩阵的平方根是比较复杂的,只有在正定矩阵中才比较简单;但这里没什么影响,我们忽略这一点。根据定义,有
第二个等式的证明类似。
从这个性质中,我们也可以看出"矩阵符号"这个称呼的含义:对于一个标量而言,,这个恒等式可以看作是它的一个自然推广。
利用这个性质,我们可以构造出一个 的近似求解方式。我们将难以求解的 部分进行泰勒展开。我们直接套用标量函数 的泰勒展开;数学家对此可能不是很乐意,但这一节本身就是一个猜解的过程,因此我们不在意。
保留到二阶,得到
于是
这就是一个求 的近似算法。下一节中,我们以此为基础构造出 Newton-Schulz 迭代,并证明这个迭代过程的收敛性。
以上内容摘自苏剑林的相关解读内容,是一个比较好理解的版本。严格来说,如果顺着 Muon 的原始 blog 去考古的话,这个 Newton-Schulz 迭代实际上是从 2008 年的一本矩阵方法的书中(Nicholas Higham 的 Functions of Matrices),牛顿法求矩阵平方根的方法中改良出来的。令 ,我们使用牛顿法求它的零点,得到
将上面的二阶展开保留到一阶能得到相同的结果,读者自证不难。
Newton-Schulz Iteration
将上面的近似公式中的系数进行参数化,得到
我们再将 SVD 分解 代入,得到
在 上应用 进行变换,其奇异向量并不变化,只是奇异值发生了变化。由于 是一个对角矩阵,所以中间一项实际上使用 对每一个奇异值进行独立的变换。
接下来,我们对 连续地应用 进行迭代。根据定理 1,我们想要获得的 实际上就是将 的所有非零奇异值都变成 1 的结果。所以我们希望确定一组参数 ,使得
这是最基础的条件。在此基础上,我们附加一些条件:
-
所有的奇异值都在 之间,用于约束求解区间。这可以通过在求解之前使用 完成(Frobenius 范数的平方等于奇异值的平方和)。这种变换并不影响最终的结果,因为 。这一点从定理 1 是显然的。
-
我们实际上还希望它收敛得快,所以我们希望曲线越陡峭越好。这比较抽象一些,下图是从 Muon 原作者的 blog 中抄出来的,或许更直观一点。这个曲线的陡峭程度很大程度上取决于 ,因为 。所以它越大越好。
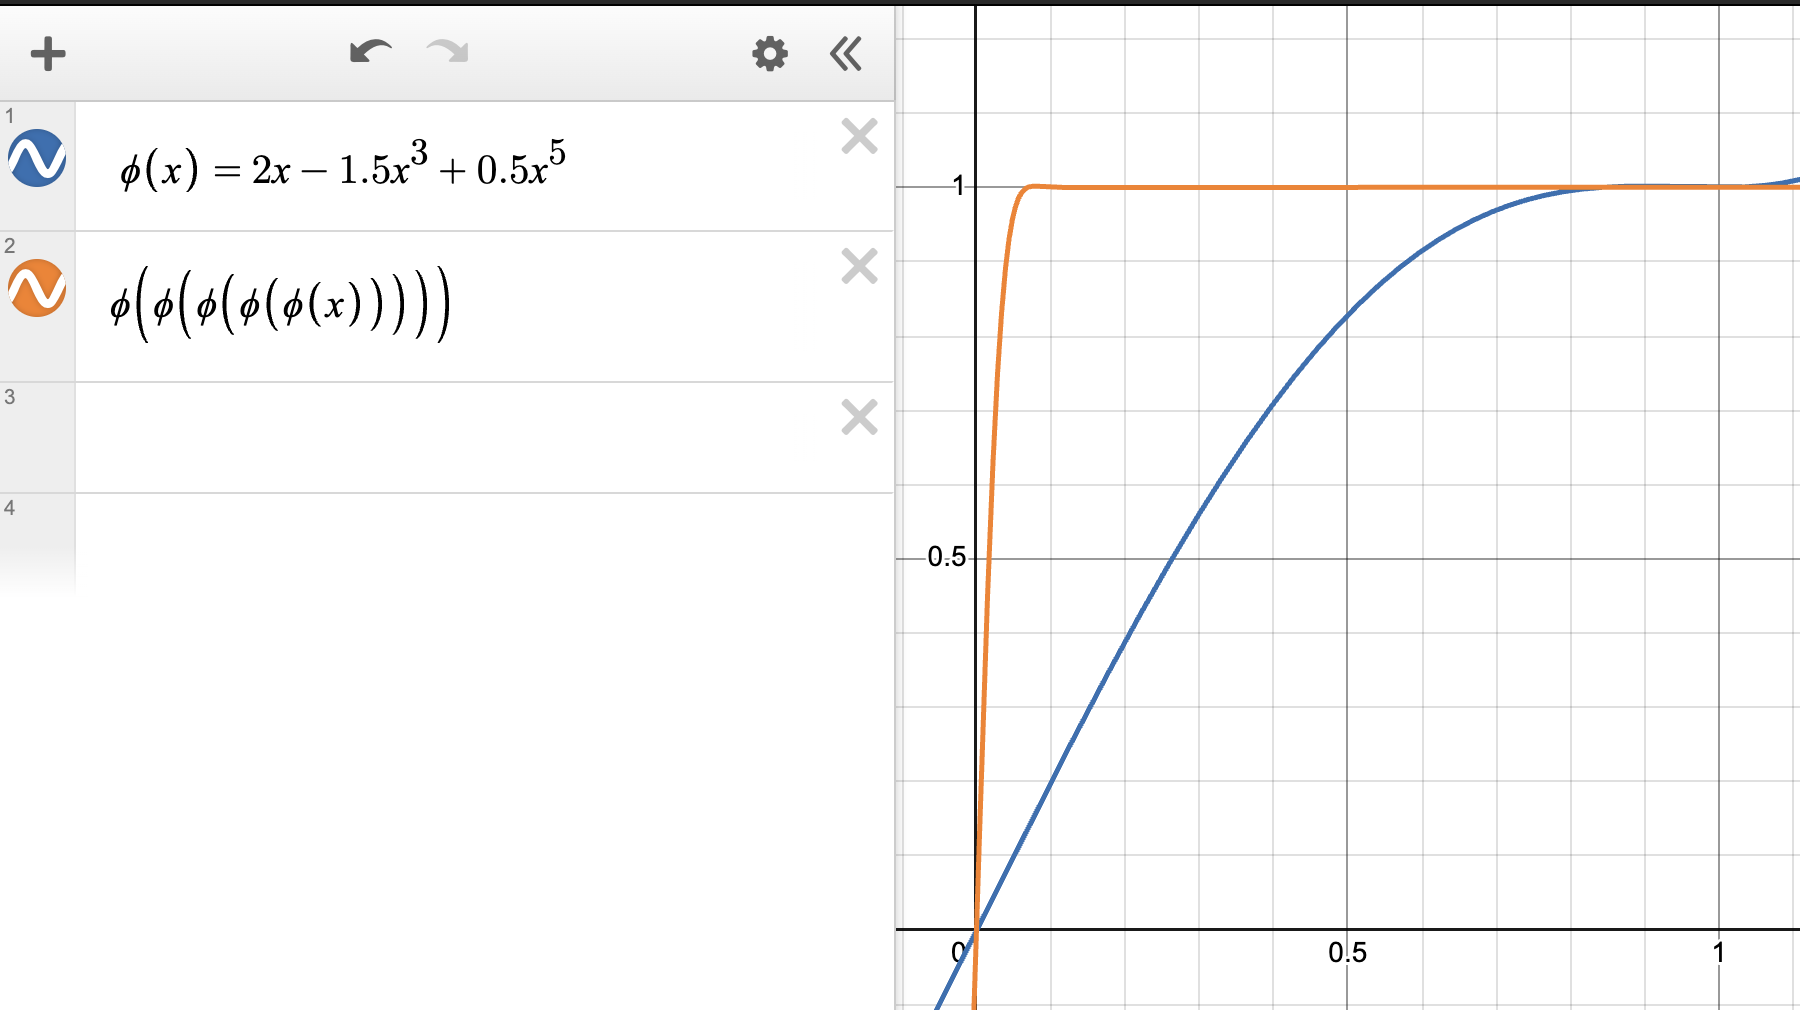
另外,作者发现 也不是非要严格收敛到 1,0.7–1.3 的范围对实际效果都不影响。在这些条件下,使用梯度下降寻找 的最优值,得到 。使用这组 magic number 进行五次迭代,所得到的就是 NewtonSchulz5 迭代。实际的 NewtonSchulz5 实现代码中不会看到 这样的形式,因为一般是使用秦九韶算法来算的。
另有一则奇闻: 这组参数最早真的只是 Muon 实现代码中的一组 magic number,以上的求解过程是作者后来在 blog 中说明的。在此之前,苏剑林就在他的文章中对这组 magic number 的求解过程进行了猜测,并且猜的结果与上述过程几乎完全一致。实际上苏剑林猜得还更详细一些。
Optimization with Norm Constraints
这一章中,我们对 Muon 为什么有用提供一个简单的解释。在 Muon 之前其实已经有类似的优化器出现,并有文章指出大部分的优化器都可以看作是在不同范数约束下对同一个问题的求解。我们从这个角度进行一些说明。
Optimal Descent Under Spectral Norm
对于一个向量参数 以及它的更新量 ,考虑以下目标:
关于这个目标可以有很多种理解。一种是理解成 的泰勒展开:
但是把 Hessian 换成了一个固定的值。优化的目标是最小化更新 之后的损失。另一种理解方式是把它看成一个受约束的优化问题,即范数约束的优化问题。这个理解有点奇怪,在 Deriving Muon 有更详细的解释,这里就先不管了。这里的范数指的是任意范数。
定义向量的对偶范数(dual norm),定义对偶映射(duality map)。上述目标的解是
其中 。
Proof. 令 ,即分解成更新的方向和更新的步长。上述目标实际上是一个关于 的二次函数,我们知道最优解是
再代回上述目标,得到
所以
再代回步长公式,两者相乘,即得证。
观察上述目标,前一项决定了更新的步长,在一般的优化器中,更新的步长由学习率决定,并不会使用数学上最优的步长,所以这一项不是很重要。重要的是后一项,它决定了更新的方向。所以上述目标表达的是:对于一个受范数约束的优化问题,其最优更新方向由梯度的对偶映射决定;范数的计算方式不同,最优的更新方向亦不同。
以上过程是在向量上推导出来的。我们默认它可以推广到矩阵的形式。此时,取范数为谱范数,我们得到
。
Proof. 注意到
觉得眼熟?是的,它和证明定理 1 时的不等式是完全一样的。注意到 也满足 的条件,所以 msign 函数就是它的解。
所以,Muon 的优化过程就是在对更新量的谱范数有约束的情况下,导出的最优更新。类似地,我们可以证明在无穷范数约束下,导出的最优更新就是 Adam(符号下降)。
Why Spectral Norm?
回忆起矩阵的谱范数实际上是一种算子范数/诱导范数(operator norm),我们类似地定义 范数:
容易证明, 范数和谱范数之间只差一个常数倍:
对于一个经典的线性层 ,当输入的 RMS 范数恒定的时候,想要在更新权重的时候约束输出的 RMS 变化,使其不要变化得太剧烈,一种方法就是去约束 的 范数,因为
所以,Muon 的约束具有维持输出变化稳定的作用。另外一方面,RMS 范数对网络的宽度不敏感,因此对不同大小的网络都能够比较好地适应。
关于 Muon 还有很多其他的有趣的理论,包括对 msign 函数是否有其他的快速求法等等(见苏剑林的基于流式幂迭代的 Muon 实现)。再看下去其他作业要写不完了,所以到此为止。关于其他延伸的理论,相关的论述放在引用中。
Variation of Muon Optimizer
Muon 的变体非常之多,很多大厂的模型在发布报告时都会提出一个稍微不同的版本,这里只介绍最基础的。首先,原始的 Muon 版本是在谱范数约束下导出的,但就像上一节所说,我们讨论得更多的实际上是 RMS 范数,所以
所以我们会得到一个稍微不同的缩放因子。这个形式通常称为 muP:
另一种是加了 Nesterov 动量的变体,将 换成了 。
写到这里的时候 DeepSeek V4 的 tech report 已经发布了,我们看看他们的 Muon 是什么样子的:
Muon Optimizer for DeepSeek-V4
Require: Learning rate , momentum , weight decay , update rescaling factor
-
for each training step do
-
for each logically independent weight do
-
// Compute gradients
-
// Accumulate momentum buffer
-
// Nesterov trick
-
// Rescale update RMS
-
// Update weight
-
end for
-
end for
可以看到也是改动了一下缩放因子,以及改变了 Newton-Schulz 的求解过程。他们的 Newton-Schulz 求解了 10 步,前 8 步使用了与上一章中相同的 magic number,后两步使用了牛顿迭代公式中参数的改良版本,让奇异值更精确地收敛到 1。
Scheme of Distributed Implementation
接下来,我们从实现的角度考察一下 Muon 优化器,并泼一点冷水:Muon 优化器至今没有一个能在 Pytorch 中直接使用的、支持现代模型并行方式的实现。截至目前,Pytorch 官方已经在 torch.optim 中集成了标准的 Muon 实现,但其分布式实现依然是 open issue。Megatron-LM 中已经有了一个 Muon 的版本,但是尚未集成到下游框架 NeMo 中。现在能够利用 Muon 进行大规模分布式训练的应该只有各个大厂内部的版本。
所以,Muon 优化器的分布式实现为什么这么困难?
我们需要先回忆一下现代 DL 框架中的并行方式。经典的分布式数据并行(DDP)假定一个 GPU 上能够放下一个完整的模型。在并行时,每个 GPU 持有一个模型的副本,但输入不同的数据,以此扩充 batch size 的大小。但这种假设在稍微大一点的 LM 中是不成立的,因此以 ZeRO/FSDP 为代表的并行实现中,模型本身,连带着优化器状态和梯度信息,都要在不同的 GPU 上进行切分。单个 GPU 只持有一部分模型的切片,以及这部分切片所对应的优化器状态和梯度信息。
那么,要怎么把一个复杂的 nn.Module 切分到不同的 GPU 上呢?一种经典的做法是将 nn.Module 中的所有参数拼接起来,拍平成一个巨大的 FlatParameter,然后在不同的 GPU 上存储这个 FlatParameter 的一个片段。并行框架会保存一个映射表,以便从 FlatParameter 中恢复出原来的模型。
这里就显示出 Muon 的特殊之处。传统的优化器,比如 Adam,是建立在标量函数的优化基础上,随后扩展到矩阵参数的。对于一个参数的切片,它也只需要这个切片对应的梯度就可以更新。然而,Muon 天生就是针对矩阵参数的优化器。Newton-Schulz5 更新这样的过程无法在梯度的切片上完成,必须在完整的梯度矩阵上进行。这意味着:
-
Muon 必须进行一次额外的 allgather,将完整的梯度分发到每个 GPU 上。相比传统的优化器,这是一次额外的通信开销。
-
就算拿到了完整的梯度,Muon 也需要将梯度从拍平的状态恢复成原来的形状才能进行 Newton-Schulz 迭代。
-
就算能够完成 Newton-Schulz 迭代,这部分计算实际上也是冗余的;每个 GPU 上都执行了相同的 Newton-Schulz 迭代过程。除非能够找到 Newton-Schulz 的分布式计算方式。
读者可能会觉得第二点看上去有点无关紧要,这不只是一点工程问题吗?但它实际上不是"一点"工程问题。需要提醒读者的是,ZeRO/FSDP 等现代并行框架设计的时间远远早于 Muon 优化器出现的时间。在 Muon 之前,没有哪个优化器会需要知道参数的布局和形状信息,因此也没有给优化器提供任何获取这些信息的机会。我们之前也提到,参数切片的映射表是由并行框架保存的,优化器没有合法的方式能够获取到这个表。当然,可能存在一些 hacking 的方式来绕过这个限制,但官方实现必然涉及到对并行框架自身的更改,因此正式的分布式实现恐怕不会有那么快出现。
针对第一点和第三点,这实际上是现在 Muon 变体发展的一个重要方向,因为额外的通信量对较大规模的训练来说是比较致命的(见 DiON)。近来比较出名的是 Newton-Schulz 迭代的流式幂实现,这种计算方式允许 Newton-Schulz5 更新被分布式地实现,这里就不赘述了。
Make DeepSpeed Great Again
这一节是追加内容。虽然没法自己写,但活还是要干的。在寻找代替品的过程中,发现 DeepSpeed 居然已经在去年把分布式的 Muon 实现接入到 ZeRO 并行策略中,真是太伟大了。commit 记录在此处,让我们鉴赏一下他们的写法:
class MuonWithAuxAdam(BaseMuonWithAuxAdam):

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)

    @torch.no_grad()
    def step(self, closure=None):
        loss = None
        if closure is not None:
            with torch.enable_grad():
                loss = closure()
        for group in self.param_groups:
            if group["use_muon"]:
                # we move the muon update part to the deepspeed's optimizer since the parameter here is a flat version
                # thus not suitable for muon update
                for p in group["params"]:
                    p.mul_(1 - group["lr"] * group["weight_decay"])
                    p.add_(p.grad.reshape(p.shape), alpha=-group["lr"])
            else:
                # ... logic of adam
        return loss
我们知道 Muon 只能优化二维的参数,所以必须把 Muon 和 Adam 混在一起用;为了写起来方便,把它们两个混在一起写成一个优化器也是一种常见的做法。我们不关心 Adam 那部分怎么更新的,所以上面的代码中只节选了和 Muon 相关的部分。
但细看感觉也不对。这是何物啊,这不是 SGD 吗?Muon 在哪里?
我们看看 runtime/zero/stage_1_and_2.py 中的改动:
# ...
from deepspeed.runtime.zero.muon.original_muon import muon_update
# ...
class DeepSpeedZeroOptimizer(ZeroOptimizer):
    # creates a flat fused tensor from the tensor list starting at the first_offset
    def get_flat_partition(self,
        tensor_list,
        first_offset,
        partition_size,
        dtype,
        device,
        param_group_idx,
        return_tensor_list=False
    ):
        # ...
        for i, tensor in enumerate(tensor_list):
            grad_accum = self.all_grad_tensors[param_group_idx][i]
            if getattr(tensor, 'use_muon', False) and #...:
                # ...
                grad_accum = muon_update(grad_accum, buffer, self.optimizer.param_groups[param_group_idx]['momentum'])
这段逻辑也是高度简化过的。与我们之前想得一样,DeepSpeed 为了兼容 Muon 修改了并行框架的流程,只不过他们做得更狠一些,直接在分发梯度之前针对 Muon 做了特判,把 Newton-Schulz 的过程写死在里面了。优化器拿到的是 Newton-Schulz 迭代的结果,直接使用 SGD 的形式更新即可。这样使得 Muon 优化器不需要对并行环境有感知,但并行环境需要对 Muon 有感知。反正他们中间总有一方需要特殊处理。
Comments NOTHING