


1. Exclusive Self Attention
标题:如题
概览:非常短的一篇文章,来自 Apple 的单人作品。核心观察是在预训练的 LLM 中,attention 用了相当的精力让一个 token 去关注自身,这通常体现在 attention map 的对角元占有相当的比例,以及 attention 的输出和 value 向量有较高的相关性上。这件事应该已经是众所周知了,这篇文章进一步指出:如果 attention 的输出中,每个 token 自身占了很大的比例,也就意味着 attention mechanism 花了相当的精力来学习 token wise 的变换,而不是去学习上下文信息的混合。这与一般认为的 attention 和 FFN 的分工是相悖的;一般我们总是认为 attention 是 token mixer,FFN 是 channel mixer(当然从数学上来看 attention 必然也有一定的 channel mixer 的成分)。并且,假设我们强制地不让 attention 部分关注 token 自身,也不会造成什么信息上的损失,因为我们还有 residual connection,总是会把当前 token 的信息补充回来的。这也是这篇文章的动机:把 attention 和 FFN 之间的分工做得再明确一些。做起来也很简单,它其实就是在标准的 attention 输出之后,把中平行于的部分去除掉。实际上就是正交化:
实验结果相比常规的 attention 总是有稳定的提升,不管是 loss 上的还是 benchmark 上的。
事实上类似的观察也不是第一次出现,之前出现的主要形式是通过在 attention mask 中排除对角元素,观点上有异曲同工之处。但是处理的方法上有一些微妙的不同。
2. Attention Residuals
标题:如题
概览:出自 Kimi,也是针对残差的一个改进。所有形式的残差连接,包括原始的 residual,highway net,以及 hyper connection,都是将前序层的输出以一定的比例追加到当前层的输出上。前面提到的三种方式都足够简单,使得这种 shortcut 总是能够通过上一层的输出和这一层的输出混合得到;换句话说,可以以 RNN 的形式得到。对于原始 residual,它的比例是 1,highway net 是一个 gating,hyper connection 则是一个更复杂的可学习形式。attention residual 的思想是将 softmax vs linear 的视角在这个方向上重现;一个层追加的 residual,由前序所有层的输出之间进行 softmax attention 的结果决定。
其实就已经说完了,剩下的所有设计都是为了计算效率的方便。每一层有一个可学习的 query 向量,当它与前序层进行 attention 时,key 是前序层的输出,value 与 key 相等。query 不是一个推理时的量,这保证了每一层算出后,后续所有层对它的 attention 就可以先行计算,而不需要等到后面再说。key 进行了 RMSNorm,是为了防止模长大的前序层输出主导 residual。
为了提高效率,attention 的层次进一步被上升到 block 级别,即多个层的输出池化(求和)得到一个块级的 key(同时也是 value),做 block 级别的 attention。再往后就是一些 infra 上的设计,这里就不看了。这样一种结构主要对 pp 带来了挑战,后面很多的优化都是 pp 的内容。
更多内容见苏剑林的介绍。诚如作者所说,这个想法实在是很直白,事实上类似的工作已经有很多了,kimi 团队也是事后才调查到。这篇文章的贡献更多地还是在 infra 侧,即如何把这样的结构 scale up。
换一个看法,随着 residual 变得越来越复杂,整个模型事实上已经快要横过来了。深度网络似乎在向浅宽度网络靠拢。那么下一步是……?
3. TransMamba
标题:TransMamba: A Sequence-Level Hybrid Transformer-Mamba Language Model
概览:想法上最接近序列内混合的一篇文章,但理论上有比较大的缺陷。文章大致的做法是对于一个序列,在中间设置一个转折点,往前的部分用 Transformer,往后的部分用 Mamba2。本意是想在短序列上利用 Transformer 的 explicit memory,长序列上利用线性结构的良好外推和推理效率。这其实有点类似于 AHN 一类的做法。在切换的地方想办法进行一次转换,使得 Mamba 能够比较好地接上 Transformer 的内容。本文最大的败笔也在这个地方,因为它的做法是使用 KV cache 加上 Mamba 的衰减从头算出 Mamba 在这个位置的 memory,说法是 Transformer 中的 K 对应于 Mamba2 中的 B,V 对应于 Mamba2 中的 x,所以它们是“等价的”。这种做法只不过是弥补了 Transformer 到 Forgetting Transformer 的一步,把 Transformer 没有 decay 而 Mamba2 有 decay 的部分补上了,对于最重要的 softmax 则完全避而不谈,事实上在它试图说明 Transformer 和 Mamba2 对应性的时候就已经把 softmax 完全丢掉了,只能得到一个烂大街的结论。从计算的角度来看,它其实在整个序列上把 Mamba2 完整地跑了一遍,然后在短序列的部分用 Transformer 的输出去进行覆盖而已。
关于转折点的设置,这篇文章使用的是利好计算效率的设置,即在复杂度最低的切分点附近进行设置。为了避免所有层同时在这个点转折带来的性能下降,它选择让每个层的转变位置之间拉开一些差距,这其实也说明它所谓的“lossless”其实并不怎么无损。
就这样一个架构宣称的性能在大部分 commonsense 上能够超越 Transformer 和 Mamba2 将近三个点,我个人是不信的。尤其是在 commonsense 上,我甚至怀疑大部分的任务长度都没有达到它设置的切换点附近。另外报告的速度和 FLOPS 能比 Mamba2 这样的纯线性结构更优,看上去就更扯淡了。代码半开源,宣称的性能也验证不了。
4. M2RNN
标题:MRNN: Non-Linear RNNs with Matrix-Valued States for Scalable Language Modeling
概览:文章非常完整,但是看完有点无语。这篇文章主要的切入点是 non-linear RNN 的复兴,大致意思就是 linear attention 在 state tracking 一类高复杂度任务上还是有限制,传统 RNN 只是因为 vector state 不够大而已,扩展到 matrix state 结果还是好的。它的做法实际上也就是这样,把传统 RNN 中的状态更新公式换成 linear attention 的形式,外围的 tanh 和门设计还保留 RNN 的风格。如下。
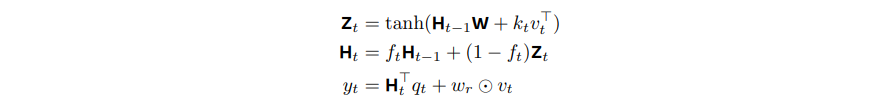
它没有解释这个是个什么东西,按照它的说法应该算作一种残差。没了,好几十页就这么一个东西。它也没有解决序列方向上的并行问题。就这样。
实验上,纯线性架构上甚至比 Mamba2 和 gated delta 可能还要弱一些,作者的解释是 state 更小,但是 state 应该是一样大的,没看出小在哪里。hybrid 的时候性能看上去倒是要好一些,不管是和 linear 混合还是和 softmax 混合,这倒是挺稀奇的。外推——指的是训练长度外推,而不是 memory 大小外推——也还不错,比常规的 hybrid 要好。state tracking 验证的是合成实验。state tracking 这类任务本来就算是特殊场景,也不见得体现在一般的 benchmark 上。
5. Loss-free Load Balancing
标题:Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts
概览:DeepSeek 的作品。因为最近总是遇到负载均衡的问题,所以看一下解决方案。一般而言,在任何涉及 topk 的场景中都有可能遇到负载均衡问题。模型可能在一开始选择了其中某几个通道,随后梯度向这几个通道回传,使得这几个通道的性能更好;其他通道没有得到学习,因此在下一轮中模型仍然倾向于选择这几个通道,最后形成所有的 token 都只激活这几个通道的场面。
一种自然的解决方式是增加一项附加损失,经典的设计在这篇文章中也有,在自己的实验代码中也有,这里就不赘述了。它确实能够解决负载坍缩的问题,但是一方面额外的损失会改变原本的梯度走向,不能保证它不会影响训练结果(实际上应该是会影响的);另一方面,多项 loss 的均衡参数也是一个问题。这篇文章试图通过一种不需要辅助损失的方式来解决这个问题。
假设有 个 export(或者其他需要经过 topk 选择的东西),它们的选择分数分别是 。这篇文章的方法是在使用 topk 进行选择时,选择的依据不再是 本身,而是 。需要注意的是,增益 只是用来选择的,topk 选择之后用于加权结果的仍然是 。这里的基本思想就是给负载大的 expert 在下一轮中附加更小的增益,从而实现其他的 expert 也能够被选择到。具体的措施是,在一个 batch 完成之后,根据当前 batch 内所有 token 的选择情况统计选择频率和平均频率,低于平均值的专家增益增加 ,反之减少 。非常简单的策略。减少的步长文中给出了消融实验,大约在 1e-3 的量级往下都是可以的,1e-2 这样的规模就会影响到收敛性了。这种 loss-free 的策略相比辅助损失能够达到更优的 pareto 前沿。
虽然解决方案很直接,但是实现上还是需要考虑一下的。参数 并不是按照正常的梯度轨迹进行更新,在 DDP 或者 ZeRO 环境下需要注意解决方案。粗想起来,比较好的方案可能是使用定制的 autograd 函数。
6. Magnitude-Aware Linear Attention & Softmax Linear Attention
标题:Rectifying Magnitude Neglect in Linear Attention & Softmax Linear Attention: Reclaiming Global Competition & Bridging the Divide: Reconsidering Softmax and Linear Attention
概览:决定把这两篇合到一起写,因为它们解决的基本上是同一个问题。一开始没有在意,但后来细想感觉还是比较有意思的。前者是来自中国科学院的工作,后者是来自上海大学经院的工作(?神了)
从数学上说,它们解决的是 linear attention 中 attention 分布锐度的问题。在经典的 softmax 中,如果对 query 的尺度进行缩放,在 softmax 中实际上相当于调整了温度,越大的尺度会导致越高的分布锐度(最终倾向于 top-1)。MALA 中证明了 softmax attention 中缩放 query 的尺度将会造成两个 token 的注意力分数比值差距以指数放大,读者自证不难。但在 linear attention 中,query(或者 key)的尺度大小并不改变 attention 分数之间的相对差距,只是改变了绝对大小;或者说,和在输出中直接乘上一个尺度是一样的。这可能会影响到最终的性能。
这里其实必须补充一点,主流的模型中其实并没有利用 query 或者 key 的尺度来改变 attention 的分布锐度,反而是在使用 RMSNorm 避免这一点,所以这个假设可能从一开始就是不成立的。Qwen 系列 QK 使用的是 Linear - RMSNorm - RoPE 这样的形式,其他模型由于用了 MLA 可能不是那么明显,但是也都有 RMSNorm。只能说,理论上 softmax 确实有这个能力,linear attention 没有。
这两篇工作都是基于这一点进行的改造。MALA 用的是最原始的带分母的 linear attention 形式,它们的解决方式是(我们先不考虑额外的 feature mapping,并想象所有原始分数都是正的):
-
对于一个 ,先把所有的原始分数 算出来。
-
算出平均数,并且将所有分数减去平均水平。
-
现在,所有的分数加起来的和是 0 了。我们需要对每一项补上一点,使其达到 1。只不过,对于原始分数高的多补一点,低的少补一点。这样分数就被锐化了。
这个公式不是很美观,见原论文。他们说实际上也没有观察到负数的 attention 分数。另外,这个锐度缩放比 softmax attention 会慢一些。
MALA 是在视觉任务上做的实验。在语言任务上比较的是 RetNet、Mamba、GLA 这三个远古模型,并且都是 commonsense,而且由于它的分母(devil in linear attention)基本没什么可看的。
另外一个视角是,如果允许这种缩放,这可以弥补 linear attention 的序列内竞争能力,这倒是比较有道理。SLA 的出发点是这个,但采用了不同的路径:他们使用 QK 再次映射到了一个逐 head 的门控,并且在 head 之间进行 softmax,然后分别对 QK 进行门控。相当于对原来的 input gating 动手脚。它们给了 GLA 和 GDN 两个变种,GLA 本身没有 input gate 也就算了,但 GDN 上它们还保留了原来的 input gate,这就很神奇了。SLA 倒是测了更广泛的任务,NIAH 有所提升,其他任务上的提升还是比较有限的。
追加一篇:后续发现其实更早的时候这个问题就被研究过了,只是表述不太一样。InLine Attention 是 2024 年的工作,他们对此的表述是不同幅度的 query 在同样的一系列 key 上进行注意时,linear attention 总是产出相同的注意分布;换言之,两个不同的 query 可能产生相同的概率分布,他们称之为不具有双射性质。解决方法和 MALA 几乎是一致的。他们还指出了一点,即这一差距在视觉上体现为 softmax 能够产生非常聚焦的注意分布,但 linear attention 总是弥散在全局。视觉任务上,这种偏置往往是局部性的,注意集中的地方就在当前 token 附近,因此他们只需要手动再把 local 的信息加上就好了(为什么不直接加个卷积呢)。但语言任务里显然不能这么做,因为聚焦的位置大多数时候不是当前 token 附近。而且 causal conv 已经把相关的信息加上了。
需要注意的是,以上工作对 linear attention 注意力分数的锐化都是有限的。从根源上来说,softmax 可以调节成最锐利的 hard max,online hard max 显然是没法解决的(应该没法吧?)。
7. delta-Mem
8. Log-Linear Sparse Attention
标题:Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
概览:这篇其实不是 linear 范围内的工作,它是针对视觉的,不过针对自回归可能也能用。它使用的方法是将 KV Cache 自底向上进行聚合,组织成一个类似 B 叉树的架构,显然这个树的高度在 左右。然后自顶向下进行查询,每层仅保留 topk 元素,这样能保证整个计算过程都在 topk 的容量内完成,其实就是以前被设想过的树状 KV Cache 组织结构。我们曾经担心的问题是这样做会不会因为上层的粒度太粗了,导致 topk 其实有一定的损失(他们用的也是池化),现在看来也还好(也可能是视觉任务导致的)。他们最后取的结果不是最底层的注意力结果,而是把各层级的结果加权聚合起来,这对视觉任务的各层级应该是有好处的。
9. RWKV7 & RWKV8
标题:什么是标题?
概览:补档。RWKV7 大家都知道了,就是 DeltaNet 基础上再加上了细粒度的输入门,现在看来这个设计也没问题,后续 KimiDelta 和 GDN2 也是沿着这个方向继续的。不过当时 RWKV7 的 kernel 可能没这么考究,可能是近似的并行化。不过我们也不是很在意这个事情,就不讨论了。
RWKV8 目前只公开了两个设计,一个是使用 embedding 替换 MLP,token id 从 embedding 前面进行直传。这更多是面向端侧的设计,因为 embedding 可以不占用 VRAM,并且不是 layer-by-layer 的结构,可以作为推理的支路异步地解出。
第二个是比较有趣的一个想法,即使用离散化的后缀自动机来替代注意力,即将某个 hidden state 临时地解码成离散的 token,在 token 序列上执行最长前缀匹配,然后在通过一个 embedding 注入回网络。他们给了一个可视化。由于涉及到采样,所以它就只能通过 STE 这样的方法来训练,不过由于 STE 的效果在 SNN 中已经知道了,这种方法对于大规模扩展并不乐观。ROSA 感觉更多是对 MQAR 和 NIAH 的一种针对性设计,但作为代价,它应该还要花很多时间去验证通用任务的可靠性。
10. Sparse Delta Memory
标题:Sparse Delta Memory: Scaling the State of Linear RNNs through Sparsity
概览:来自 Facebook Research 的作品,是关于稀疏扩展的。基础是一篇 2019 年的文章,其中描述了 PKM(Product-Key Memory),前段时间 Sakana AI 应该也有一个基于此的工作,具体名称忘了。这篇文章还是讲得比较清楚的,实际上就是把 memory entry 的数量扩大到任意的 ,在 topk 选择时,只需要做一个 的投影,然后将它拆成两半,互相外积,这样就得到了 个分数。这个 topk 的选择过程中,实际上不需要实例化完整的 维向量,从而达到高效的扩展。实验上,这篇文章使用的是 local-global 混合,即多层 SWA 混合一层 GDN/Attn/SDM。召回依然严格弱于 Attn。
11. Hedgehog Attention
标题:The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry
概览:在 arxiv 上挖坟找到的文章。核心其实和上面的 6(MALA & SLA)是差不多的,就是两个观点:linear attention 无法实现高度集中的注意分布;QK 点积的增长在 softmax attention 中一定会带来注意力比重的增加,在 linear attention w/ feature map 中则未必。
12. Test-time regression
标题:Test-time regression: a unifying framework for designing sequence models with associative memory
13. MHLA
标题:MHLA: Restoring Expressivity of Linear Attention via Token-Level Multi-Head
概览:很有误导性的名字,实际上跟 multihead 没什么关系。出发点和 6 是一样的,还是老生常谈的缺陷,即 linear attention 的 attention map 秩不够,分布不够集中/稀疏,或者说分布的熵不够低,都是一回事。它的方法实际上也简单:经典 attention 需要对每一个 query 进行重新打分,经典 linear attention 对所有的 query 都不会重新调整 kv 对的权重,那么取一个中间量,在块的级别上进行重新打分,这总是可接受的。将序列划分成 块,并学习一个 的参数矩阵,对于第 块的 query 向第 块的 key 请求时,使用 对该段的 KV 对进行重新缩放,这样达到块级的重分配的效果。不过这样是没法维护一个 的恒定记忆的,它的记忆空间实际上是 ,是常规的 倍;按照文中的设置来看,这个量一点也不小,在 2k 上下文上就达到了 32 左右。它也没有说明超出上下文长度怎么办, 显然是一个预定义的参数。作者显然认识到了这一点,这对于其他 linear 变种而言是一个不公平的比较。把它看成一种 state expansion 的方式可能会好一些。
Comments NOTHING